唐霖峰
信息融合 | 图像增强 | 视觉-语义理解
我是 唐霖峰,现为武汉大学机器人学院博士后,合作导师为 马佳义教授。
我于 2025 年 12 月获武汉大学电子信息学院博士学位,于 2020 年获中南大学学士学位。研究方向聚焦信息融合、图像增强与视觉-语义理解。2025、2026 年连续入选 斯坦福大学发布的全球前 2% 顶尖科学家榜单,并获得两项最佳论文奖:钱学森论文奖(IEEE/CAA JAS 最佳论文奖,2023)和 Information Fusion 最佳论文奖(2024)。
以第一作者发表论文 18 篇,其中包括 CCF A 类论文 8 篇、ESI 热点论文 6 篇(前 0.1%)和 ESI 高被引论文 9 篇(前 1%)。
研究方向
信息融合
红外-可见光图像融合、多模态视频融合、可控融合,以及配准与融合联合建模。
图像增强
低照度图像增强、退化感知恢复,以及基于扩散模型的图像恢复方法。
视觉-语义理解
视觉-语义学习、语言-视觉先验,以及面向检测、分割等高层视觉任务的图像融合模型。
科研项目
国家自然科学基金
青年科学基金项目(C类)
跨层次视觉-语义协同的可控鲁棒多模图像融合理论与方法研究
中国博士后科学基金会
国家资助博士后研究人员计划B档
感知-认知协同的多源异构遥感影像鲁棒融合与可信解译方法研究
中国博士后科学基金会
第 79 批面上资助
面向开放场景的多源图像融合感知协同理论及方法研究
省级科研资助
省级青年基金
生成式多源图像自适应融合与可信感知一体化方法研究
省级项目资助
湖北省博士后尖端人才引进项目
代表性工作
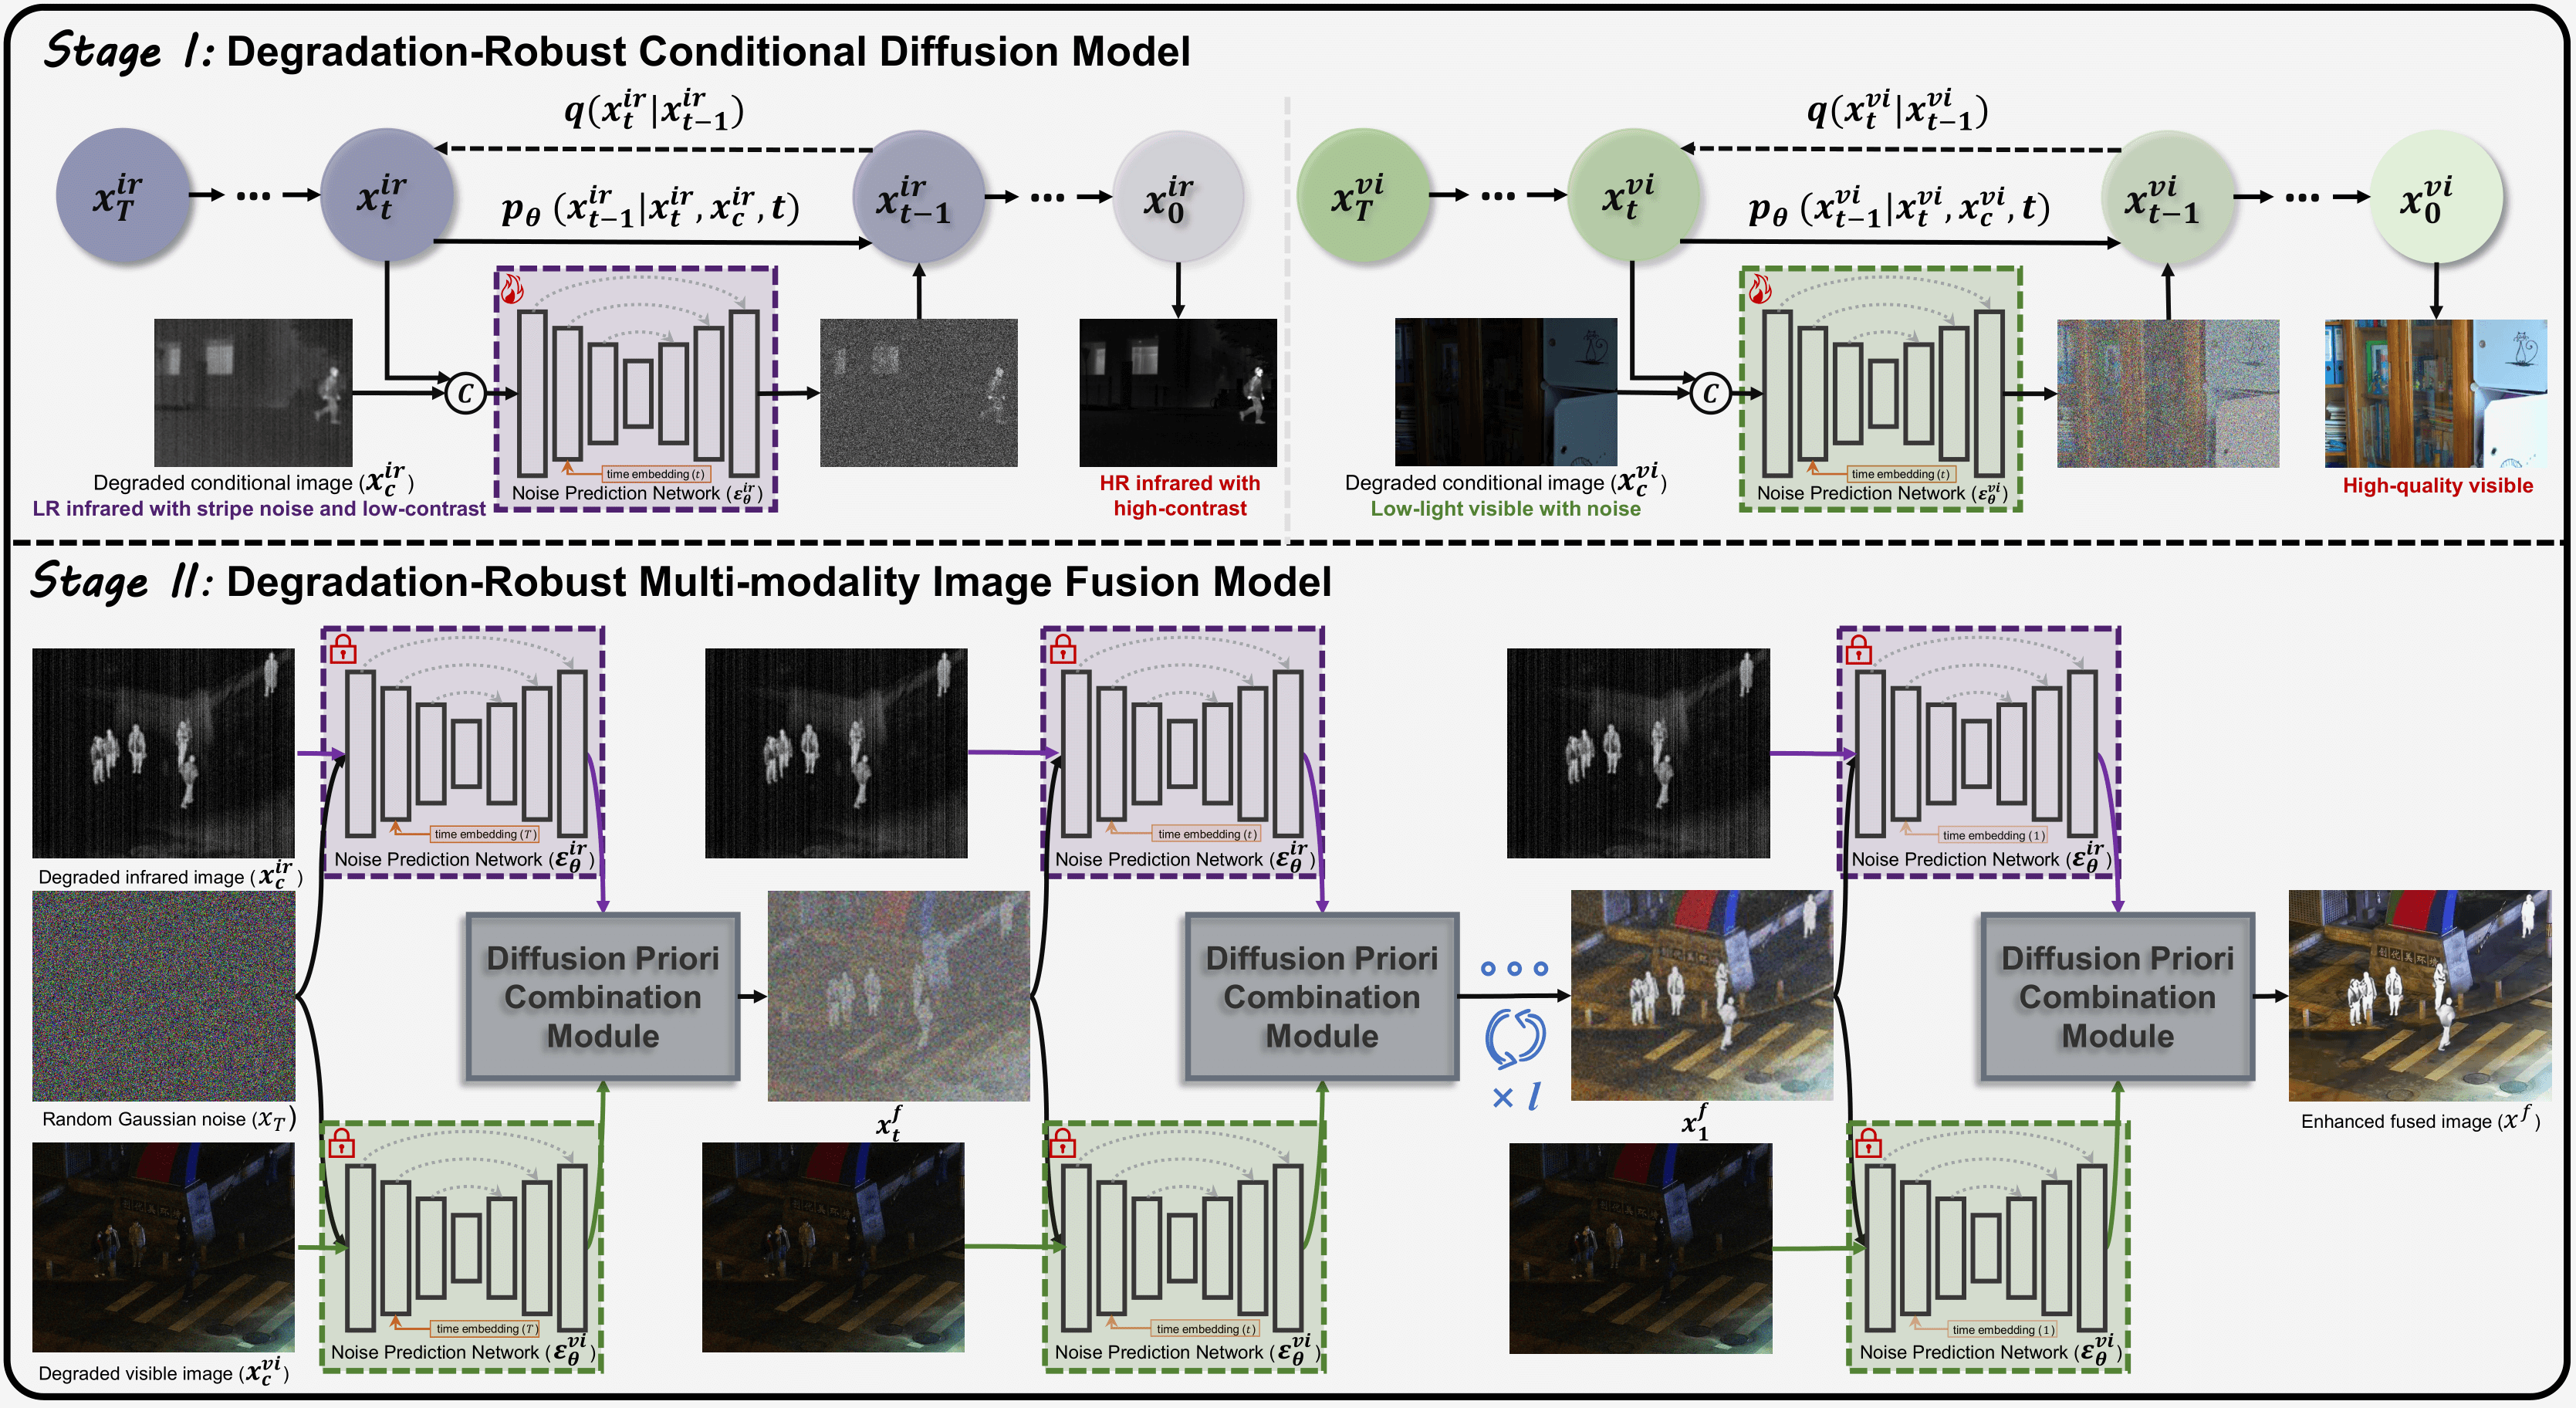
Mask-DiFuser
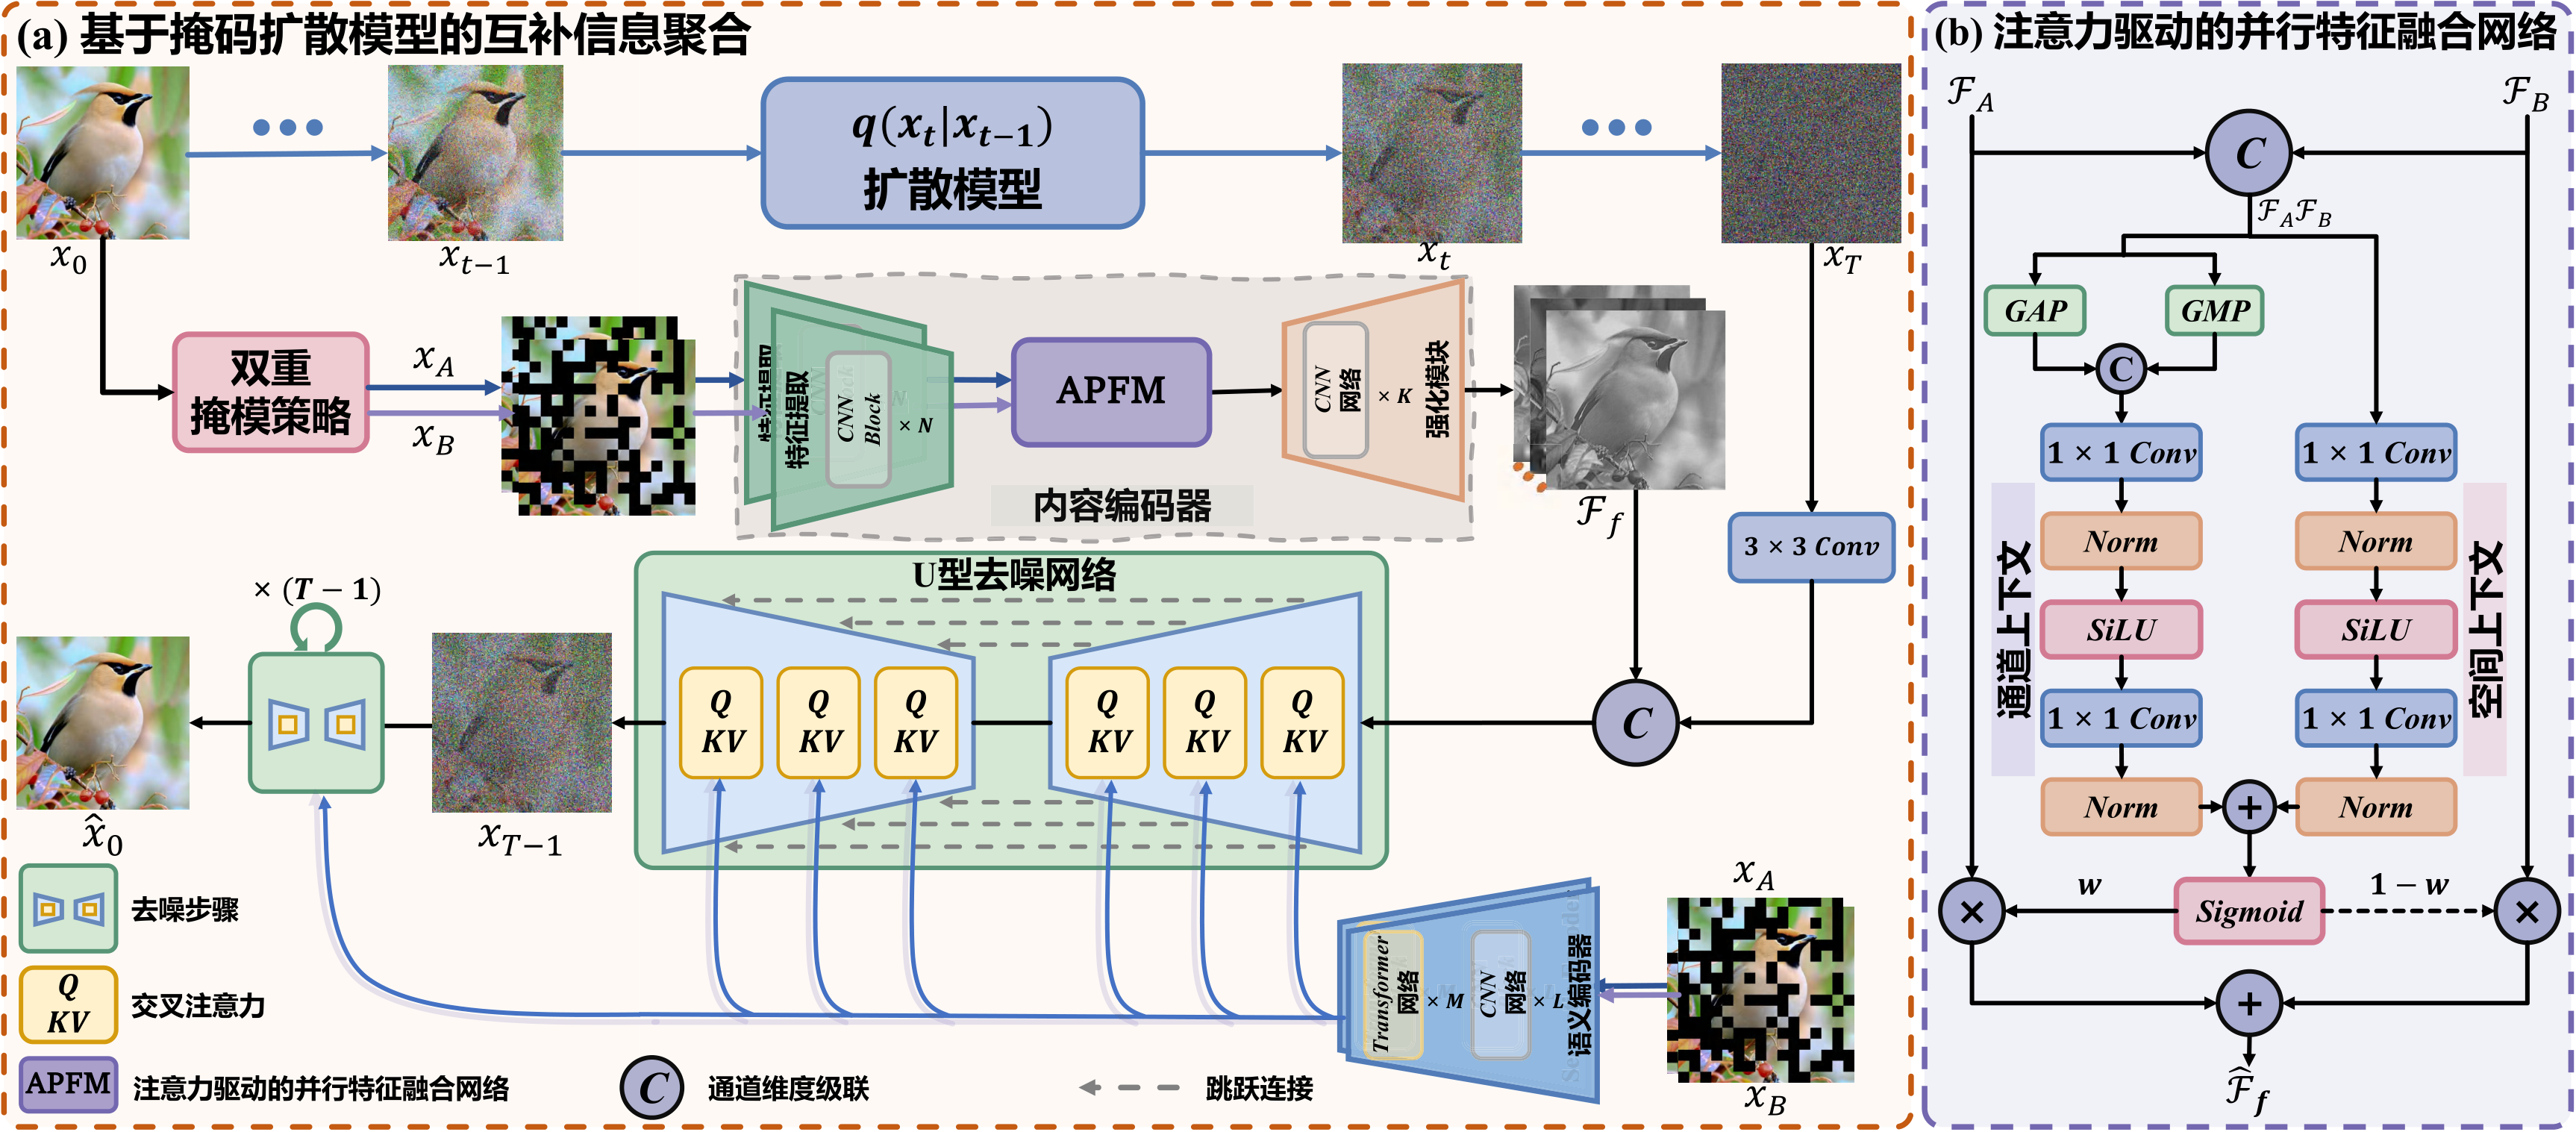
IEEE Transactions on Pattern Analysis and Machine Intelligence (TPAMI),2026
以掩码扩散模型统一建模多种无监督图像融合任务。
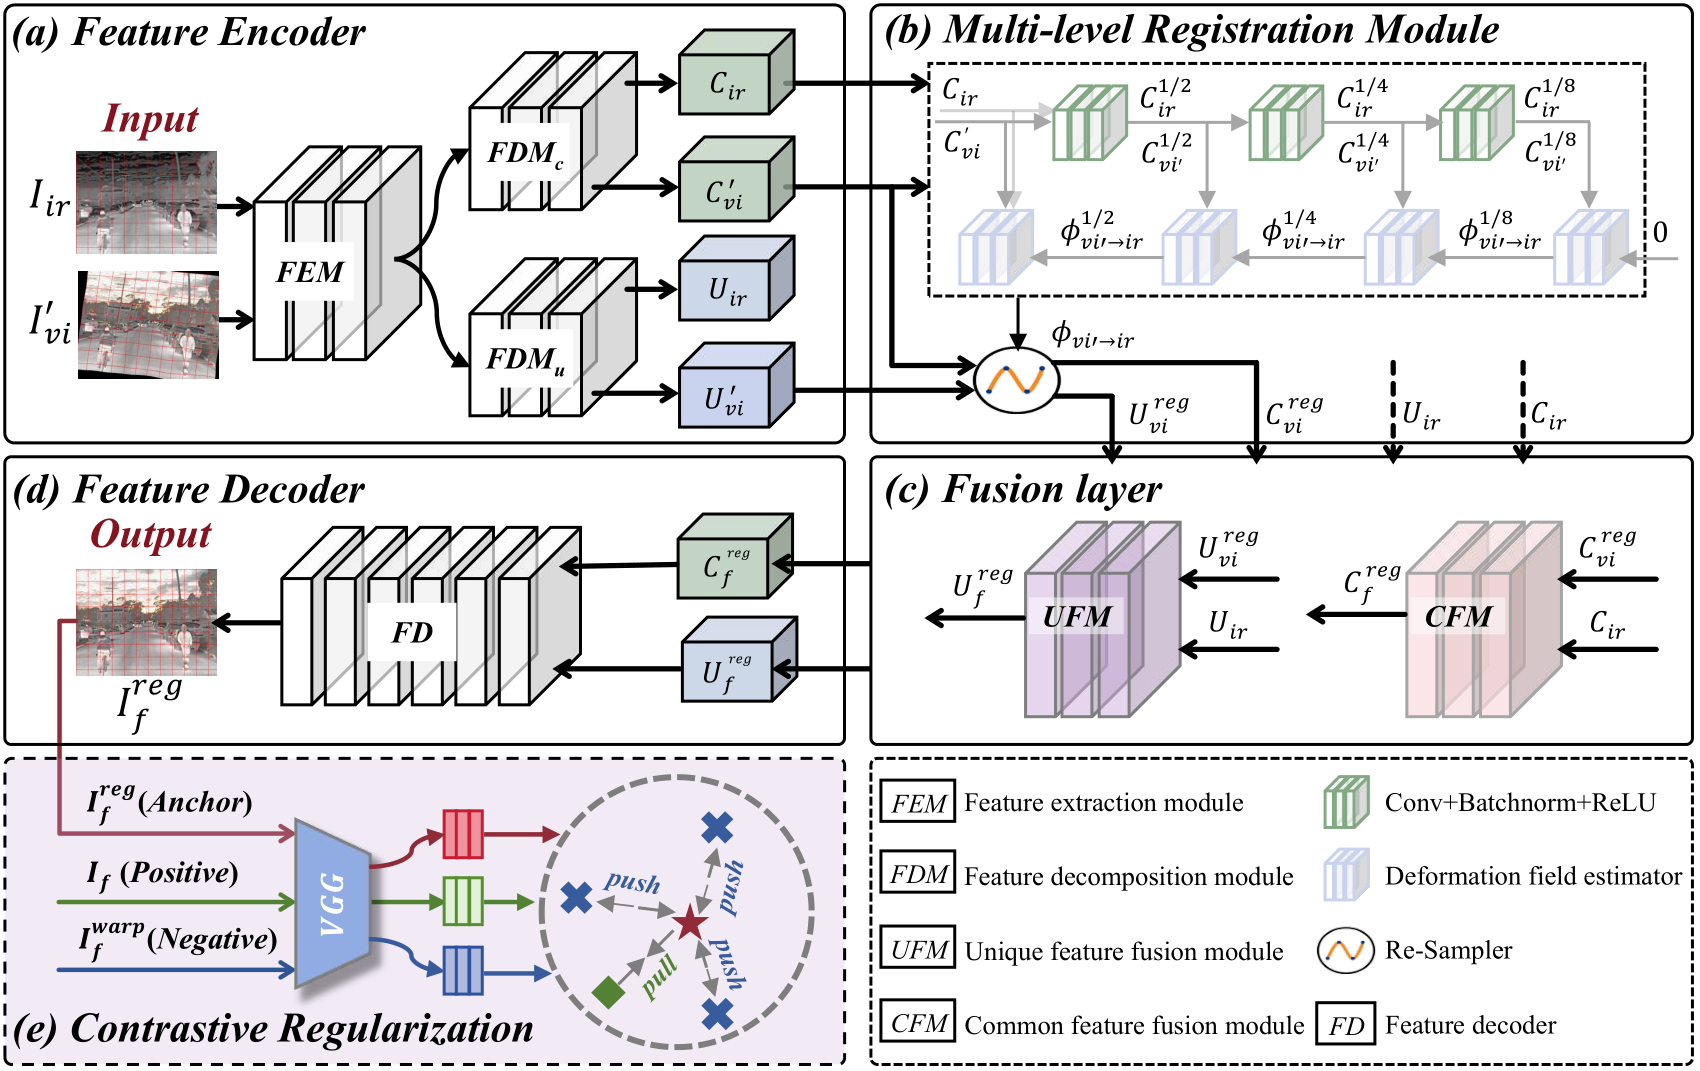
C2RF
International Journal of Computer Vision (IJCV),2025
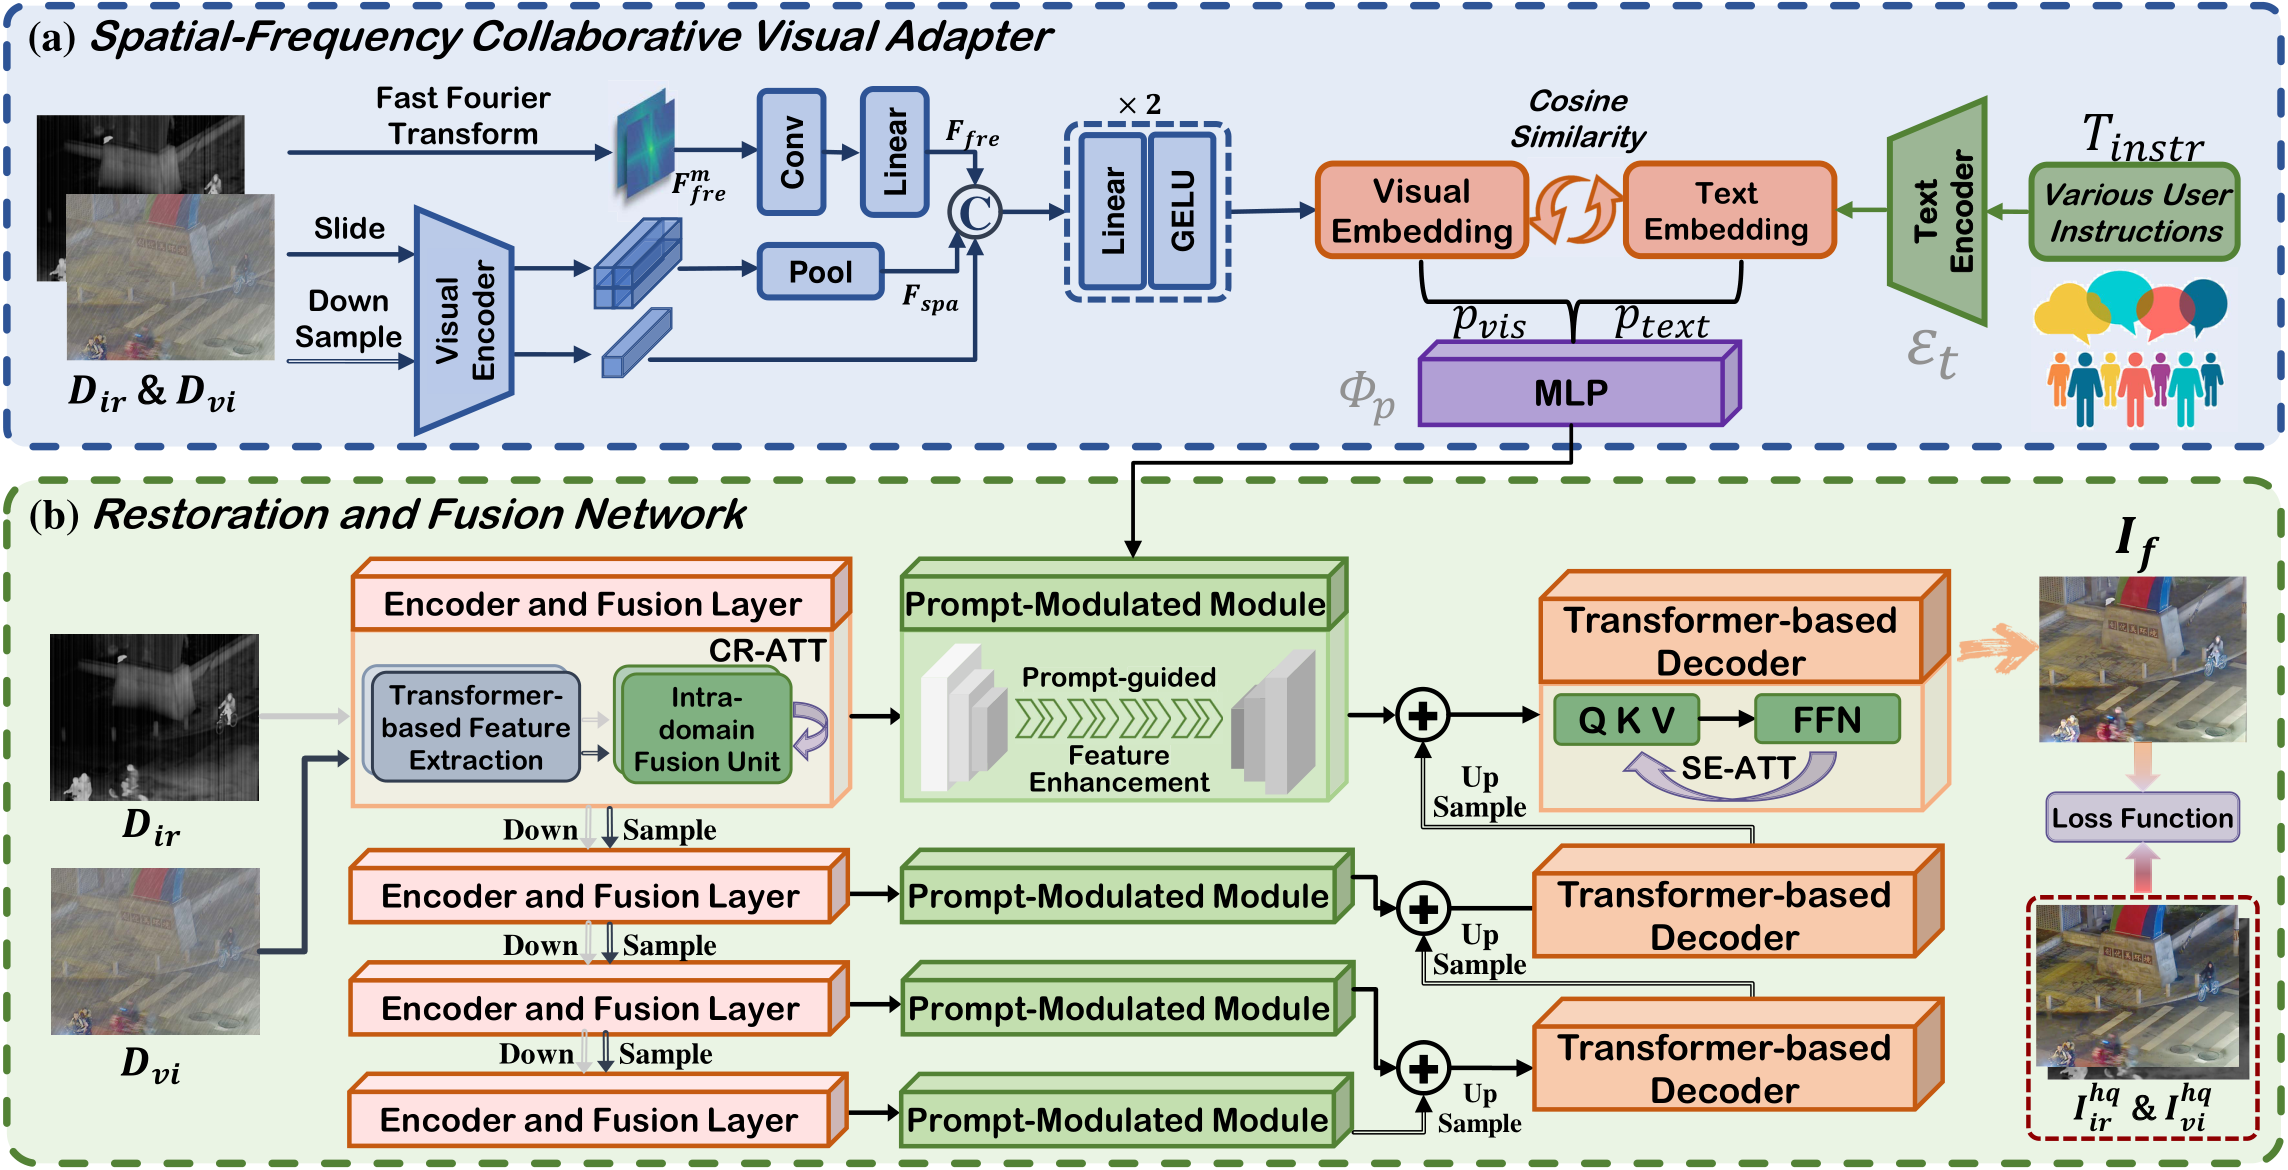
ControlFusion
Advances in Neural Information Processing Systems (NeurIPS),2025
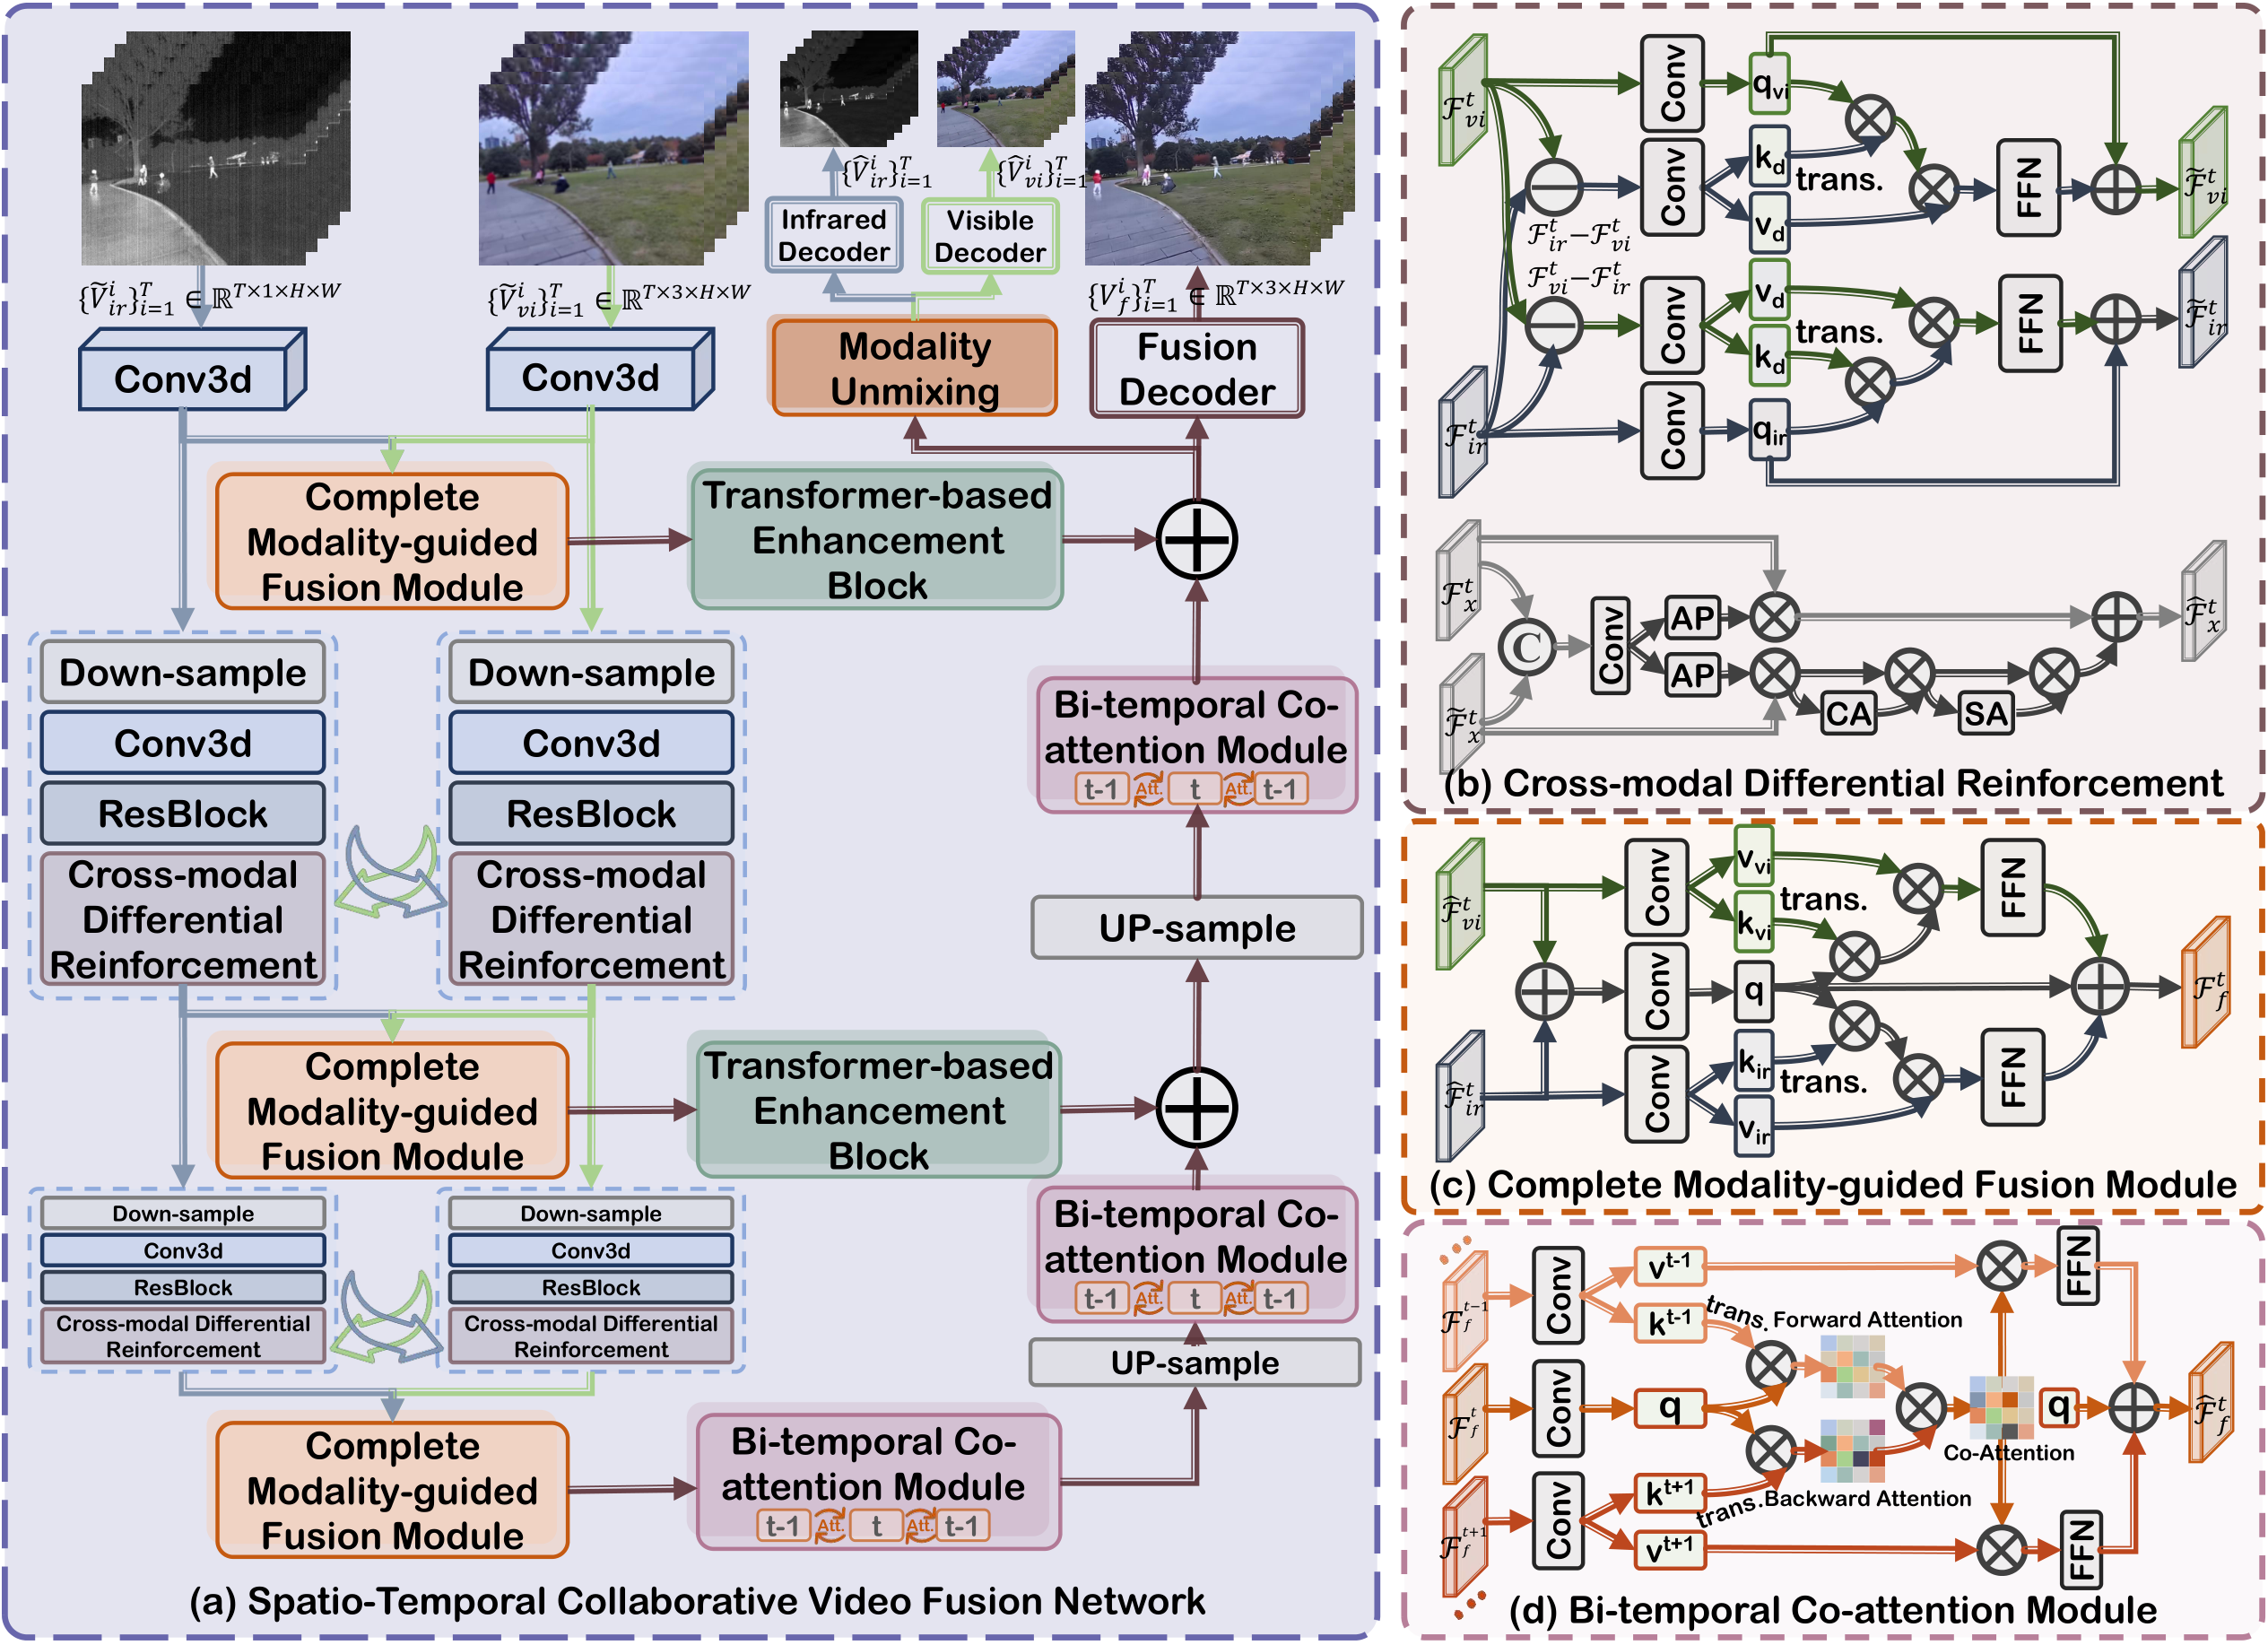
VideoFusion
IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR),2026
SwinFusion
IEEE/CAA Journal of Automatica Sinica,2022
利用 Swin Transformer 建模跨域长程依赖,实现通用图像融合。
SeAFusion
Information Fusion,2022
将语义感知与高层视觉任务反馈引入实时红外-可见光融合。
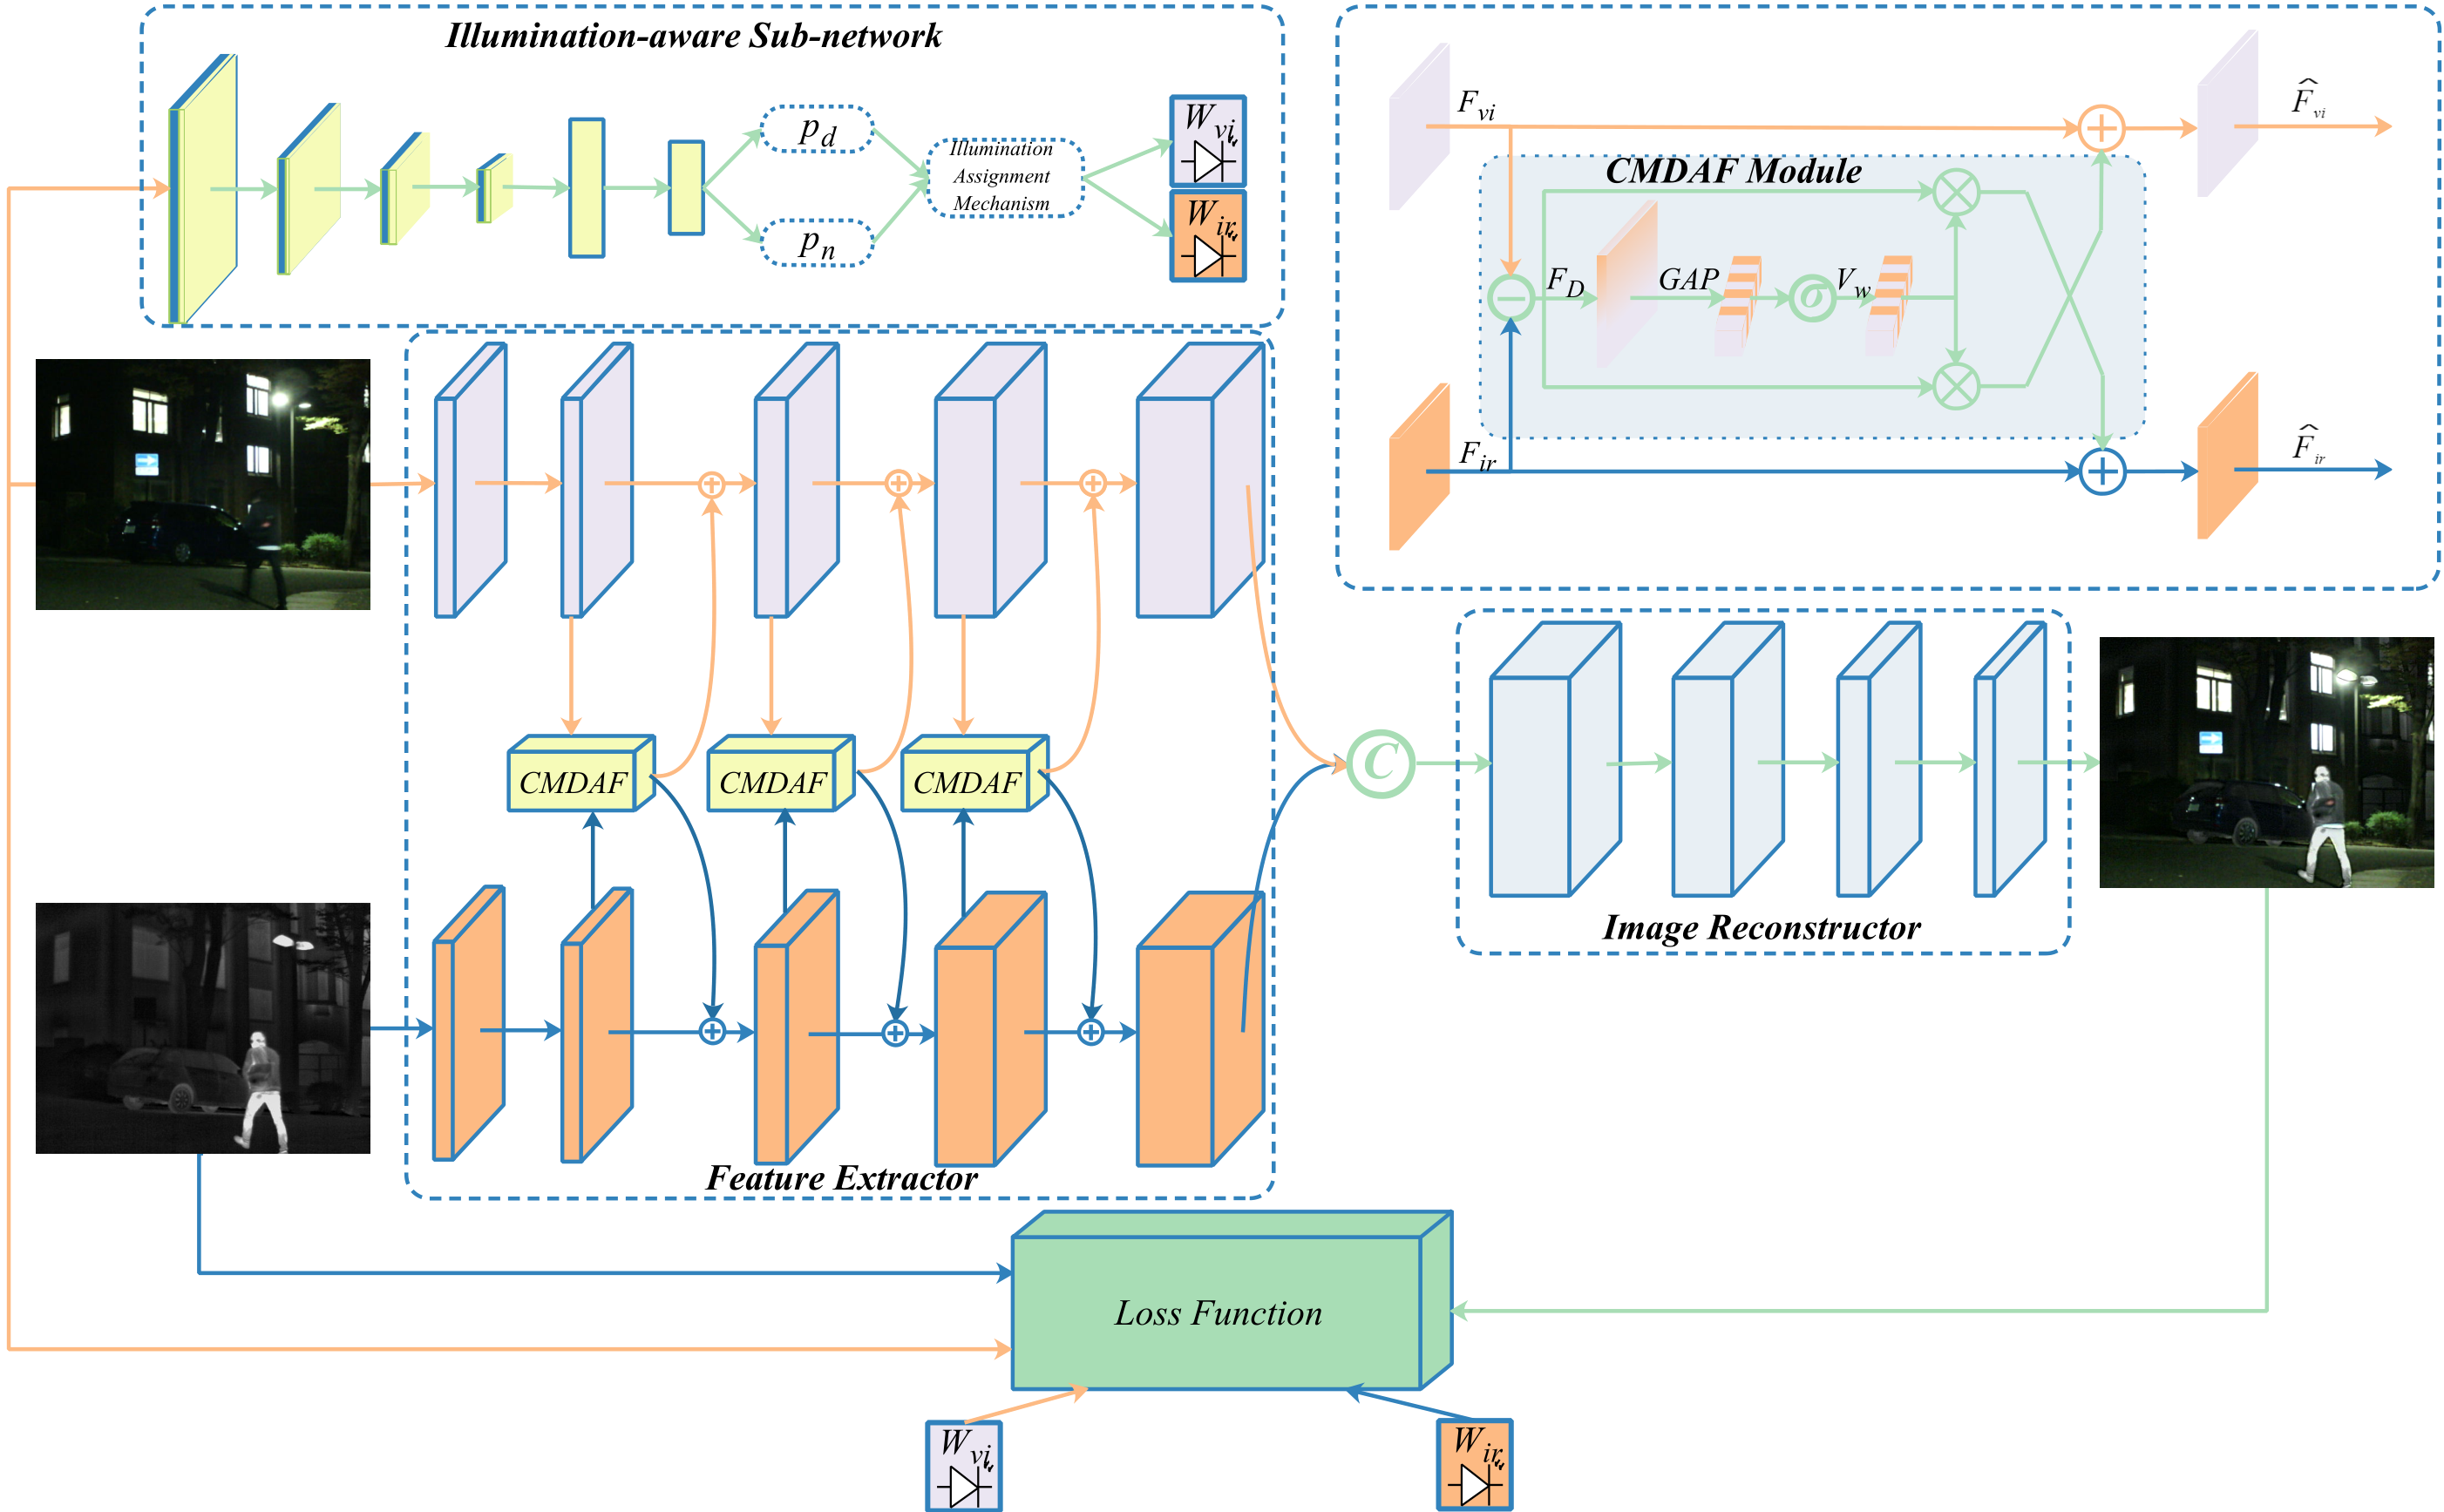
PIAFusion
Information Fusion,2022
依据光照条件渐进融合红外与可见光信息。
SuperFusion
IEEE/CAA Journal of Automatica Sinica,2022
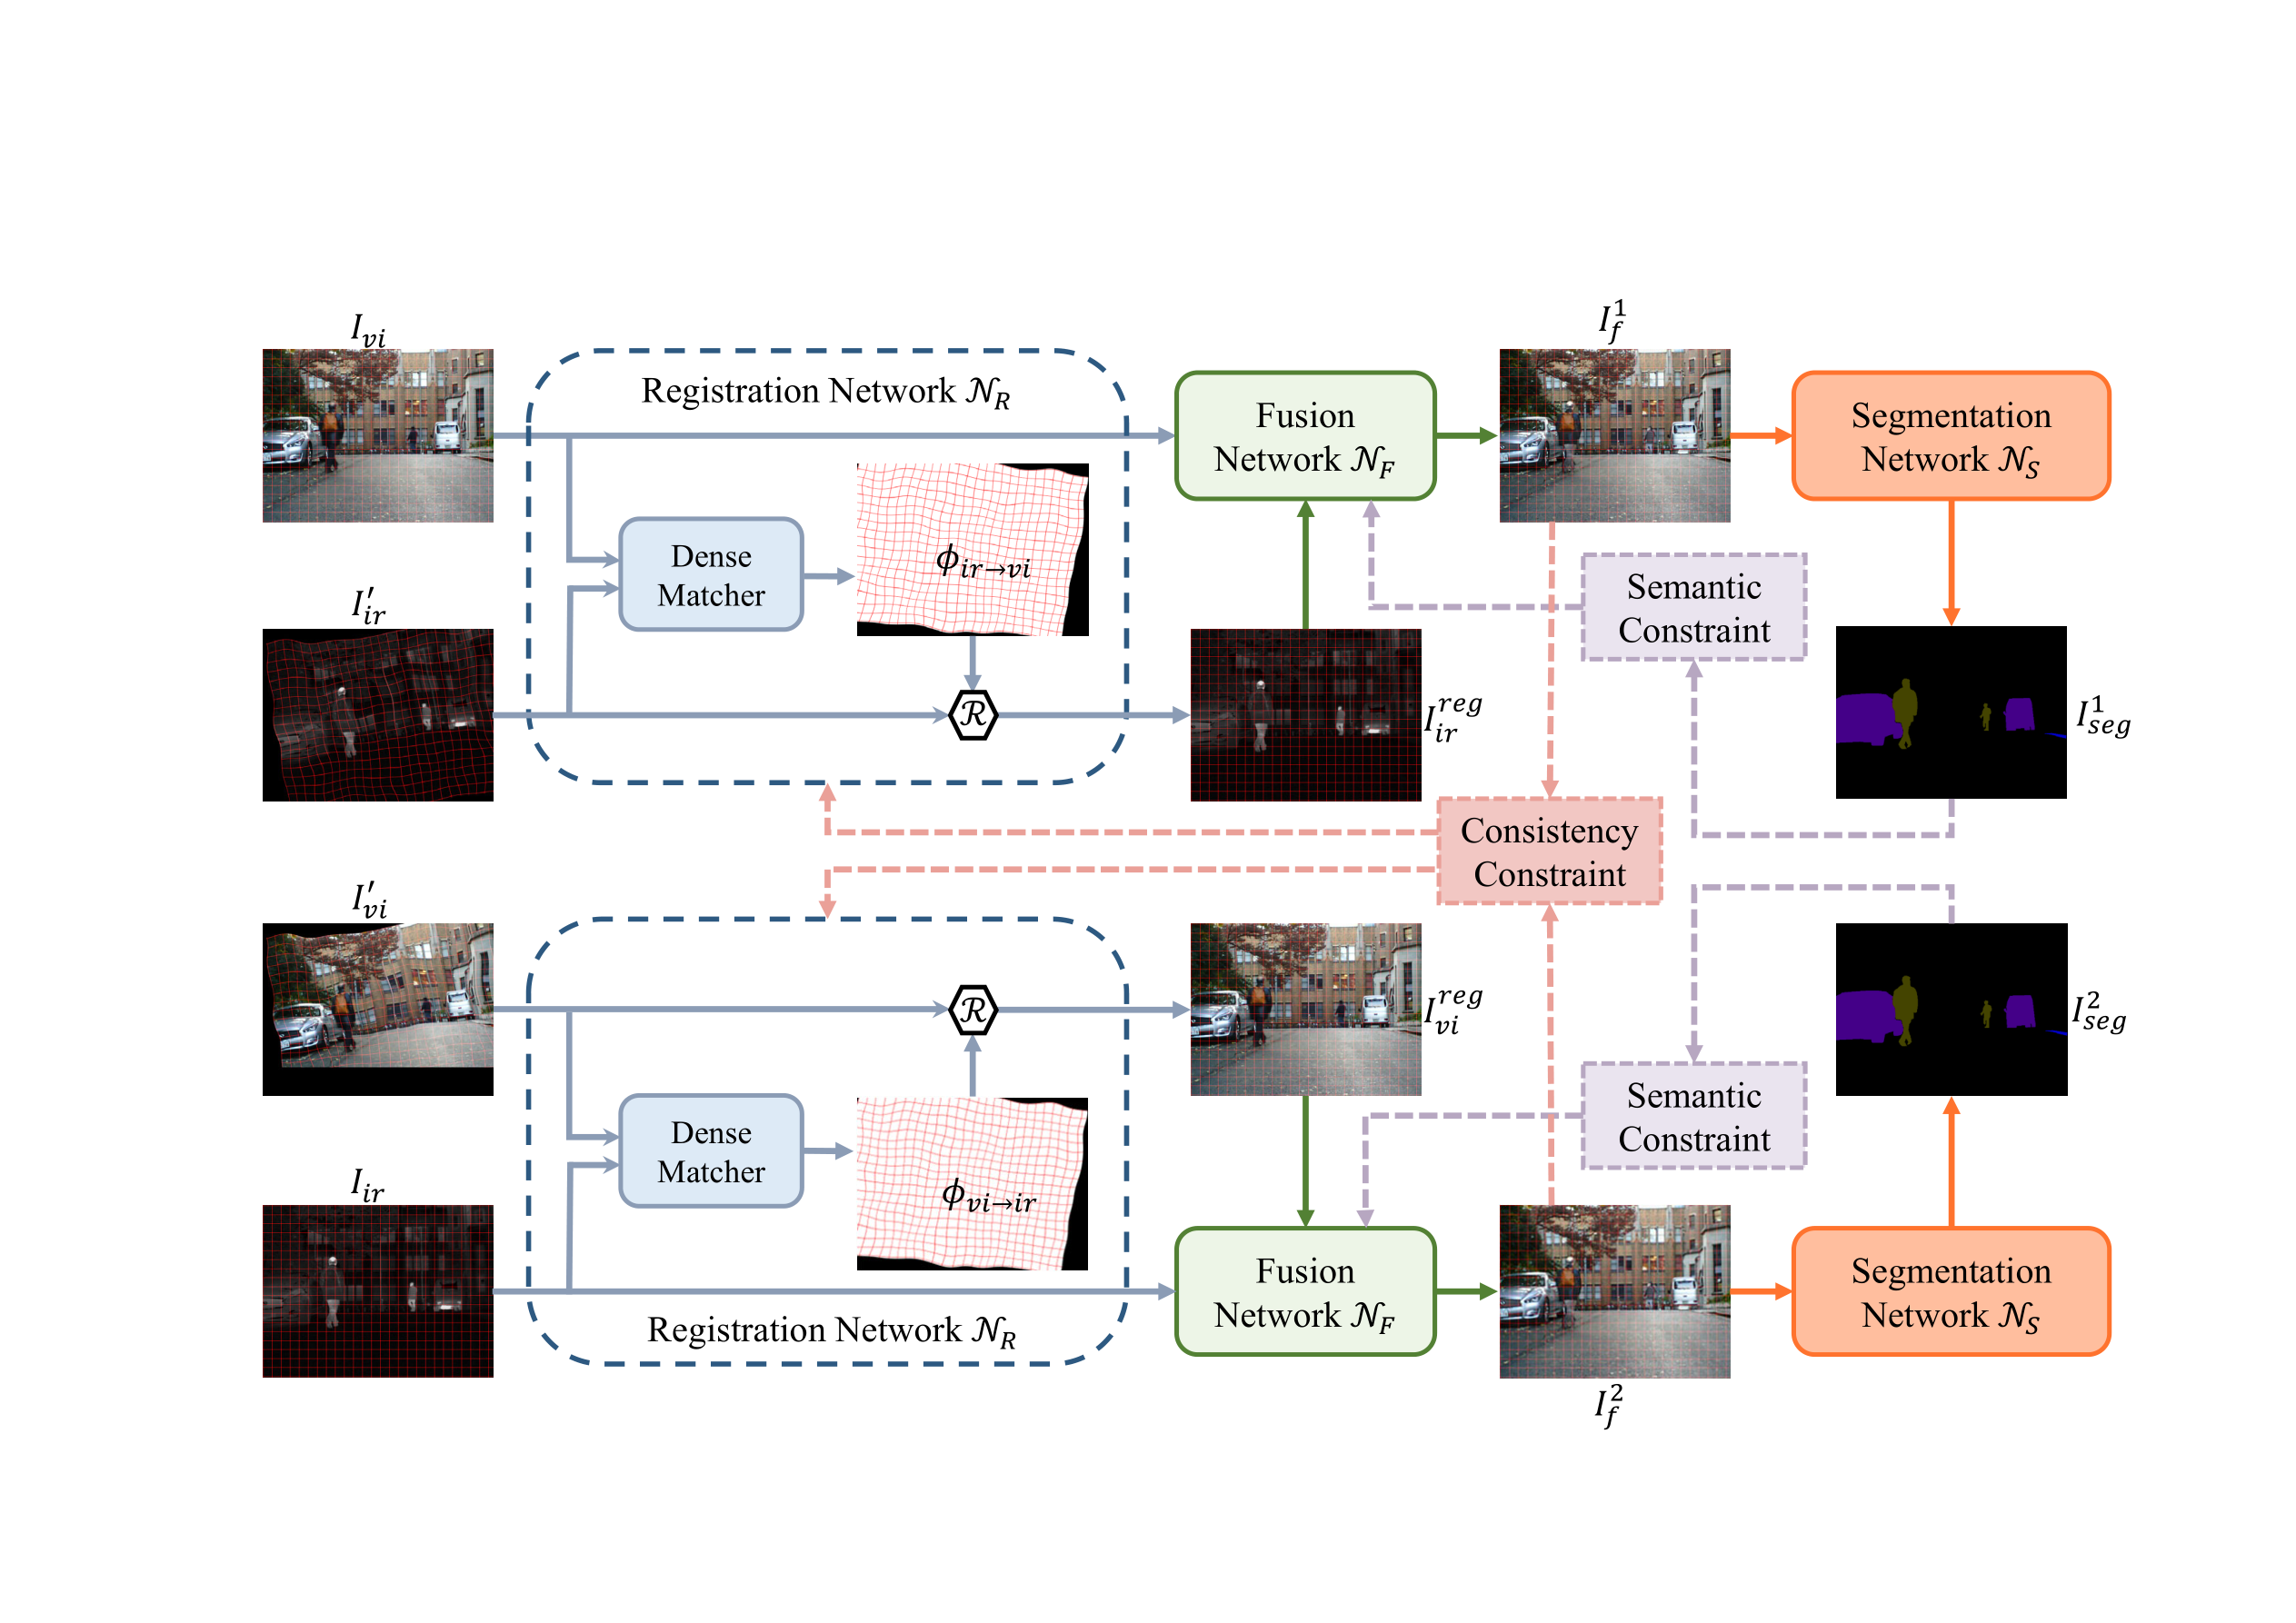
联合图像配准与语义感知融合,面向空间未对齐的多模态输入。
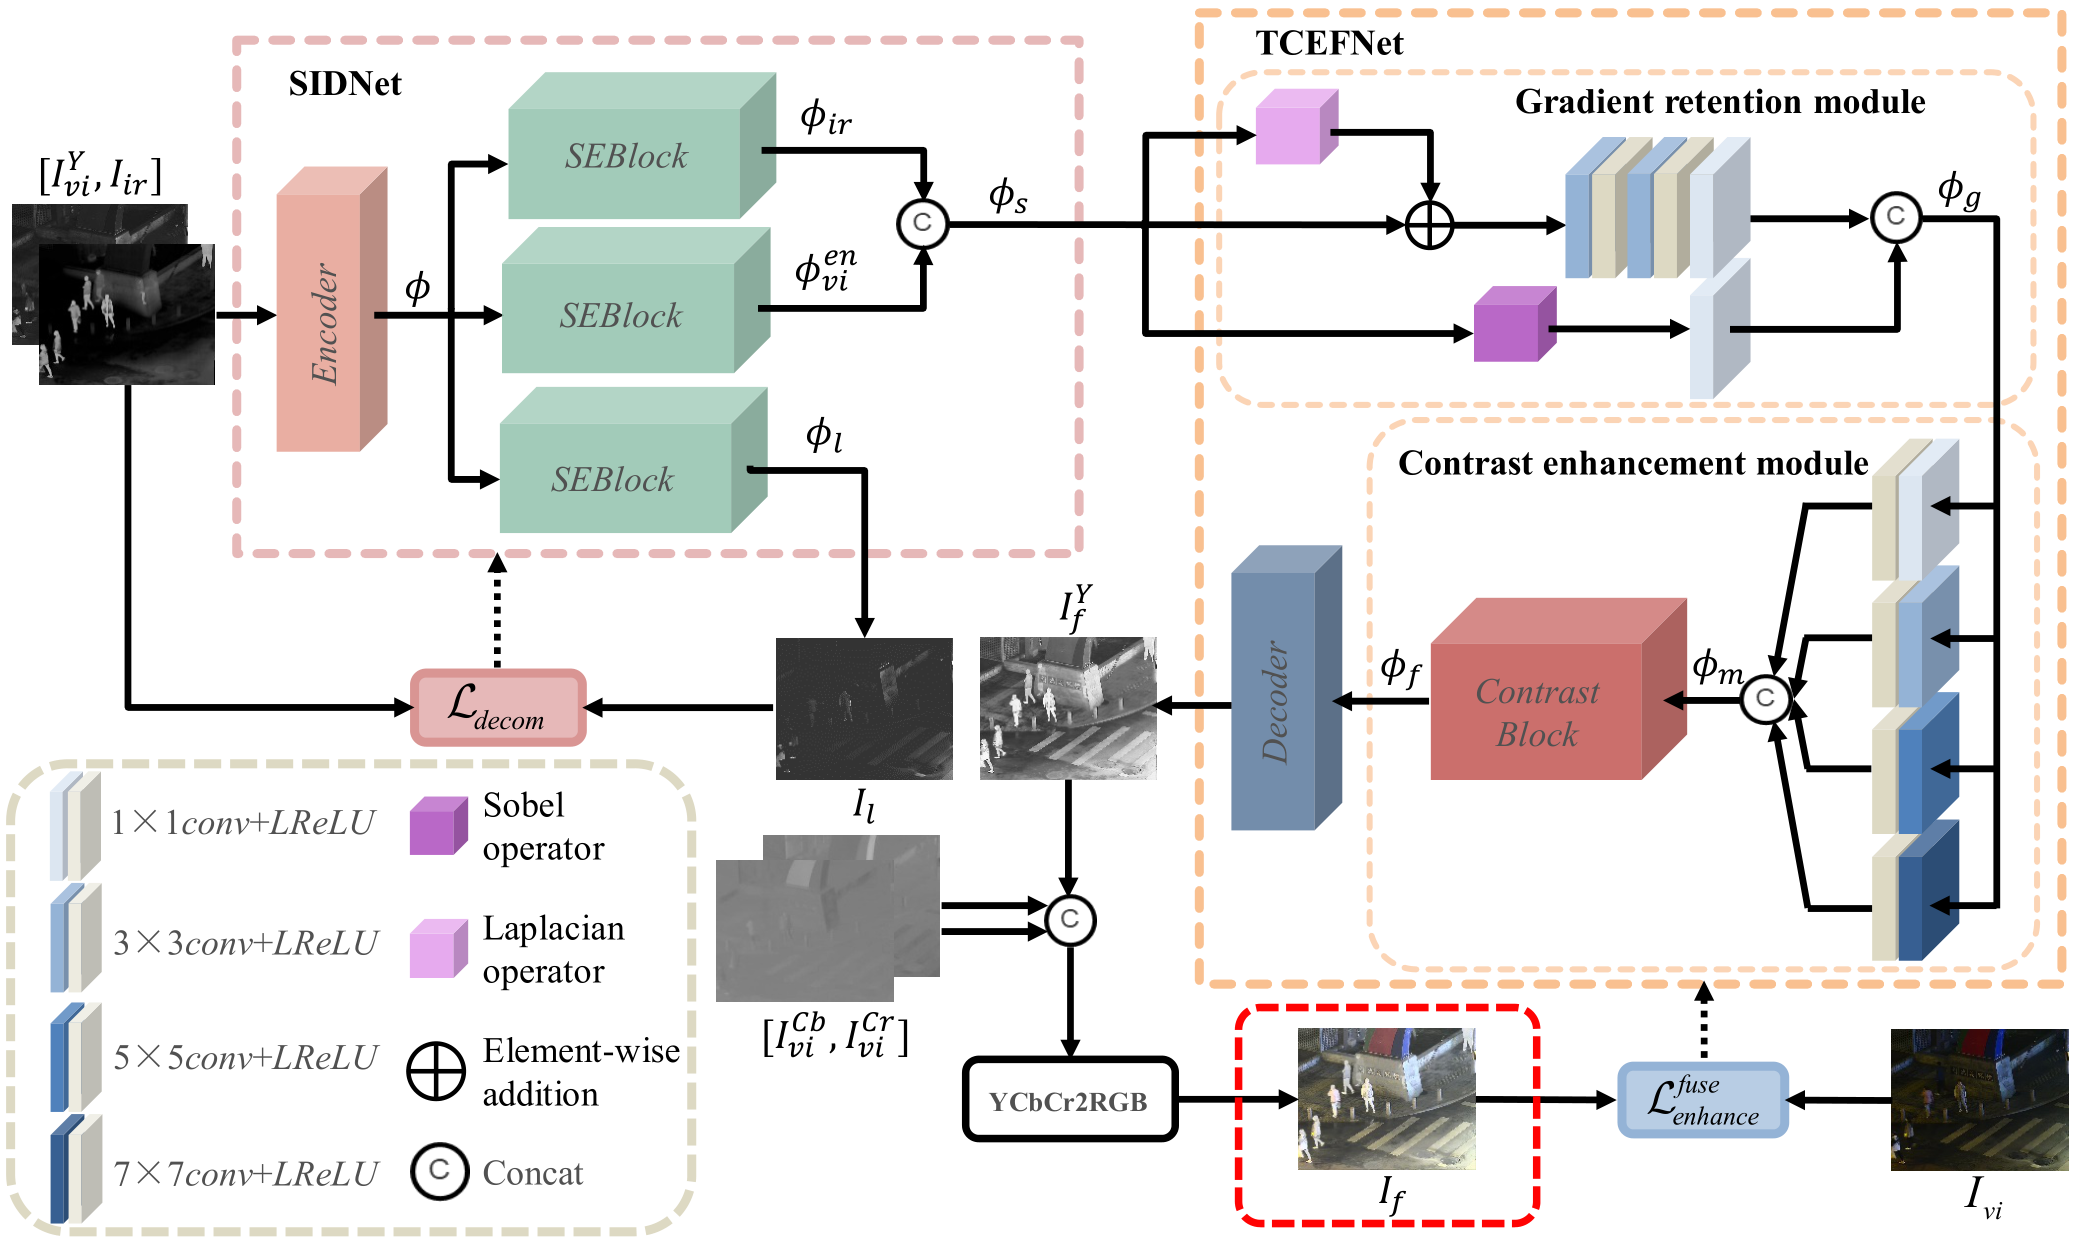
DIVFusion
Information Fusion,2023
面向低照度场景抑制暗区并增强融合细节可见性。
PSFusion
Information Fusion,2023
通过语义注入与场景保真协同优化低层融合质量和高层任务。
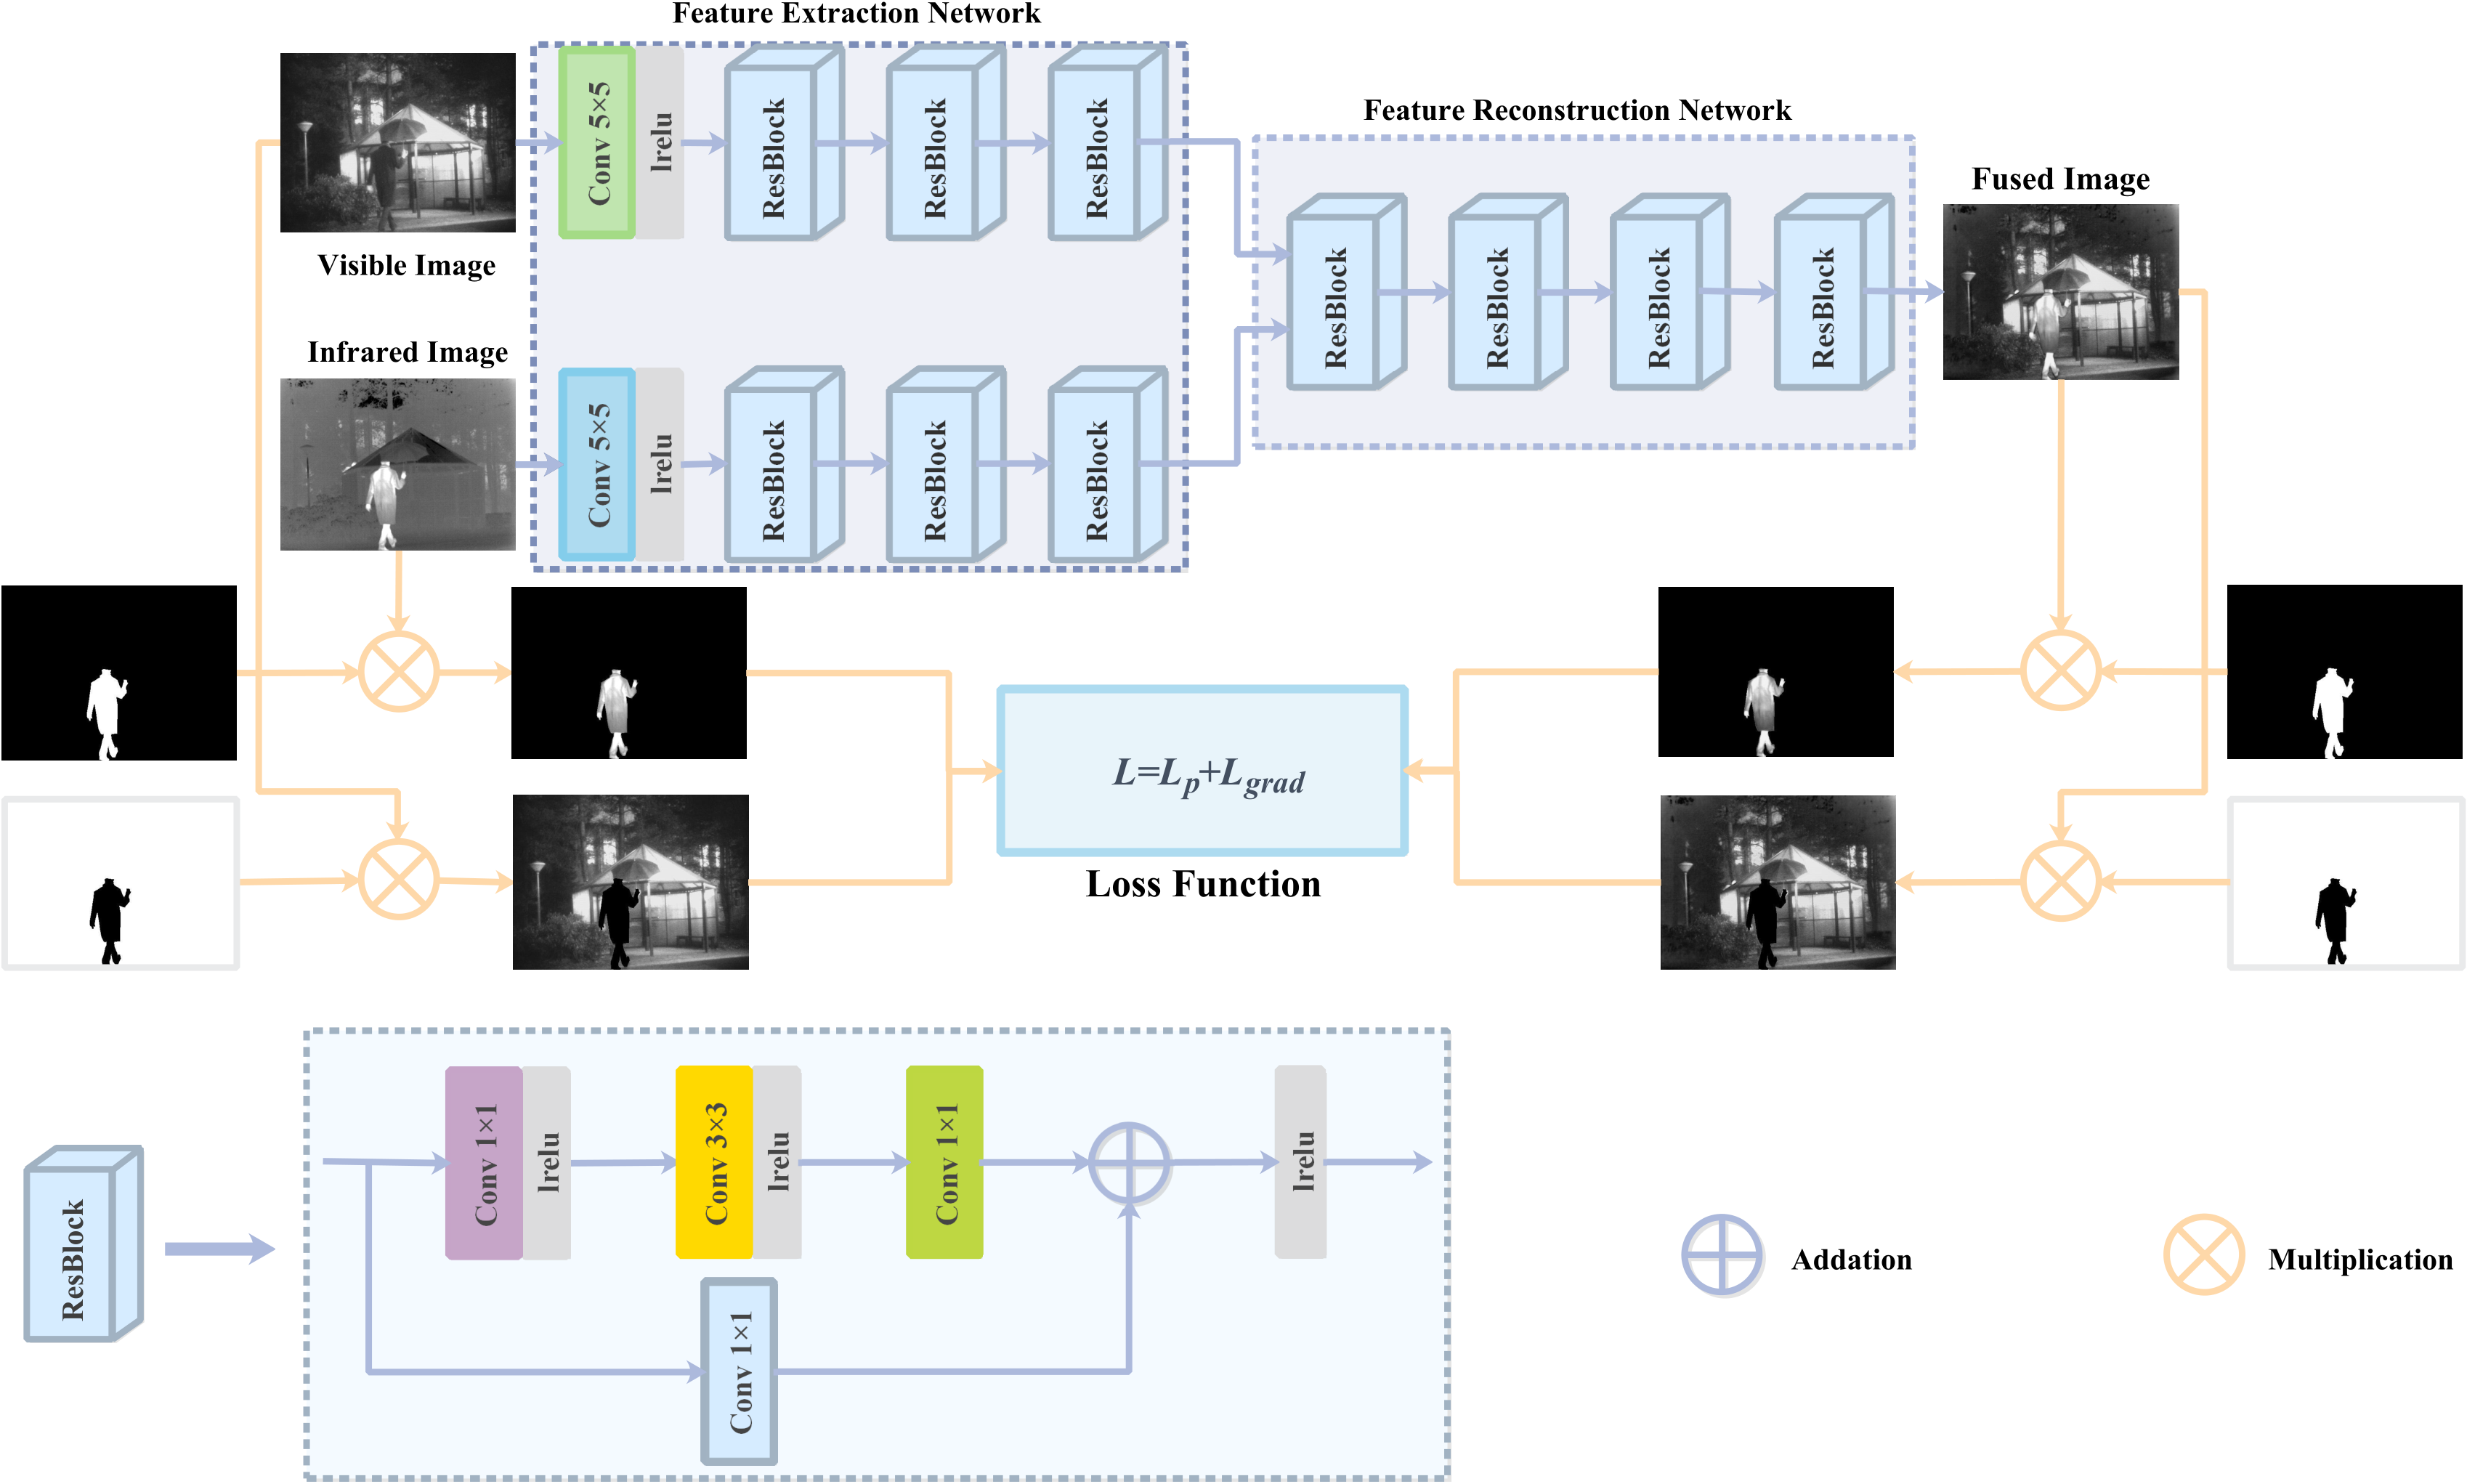
STDFusionNet
IEEE Transactions on Instrumentation and Measurement,2021
利用显著目标检测保留关键热目标与结构信息。
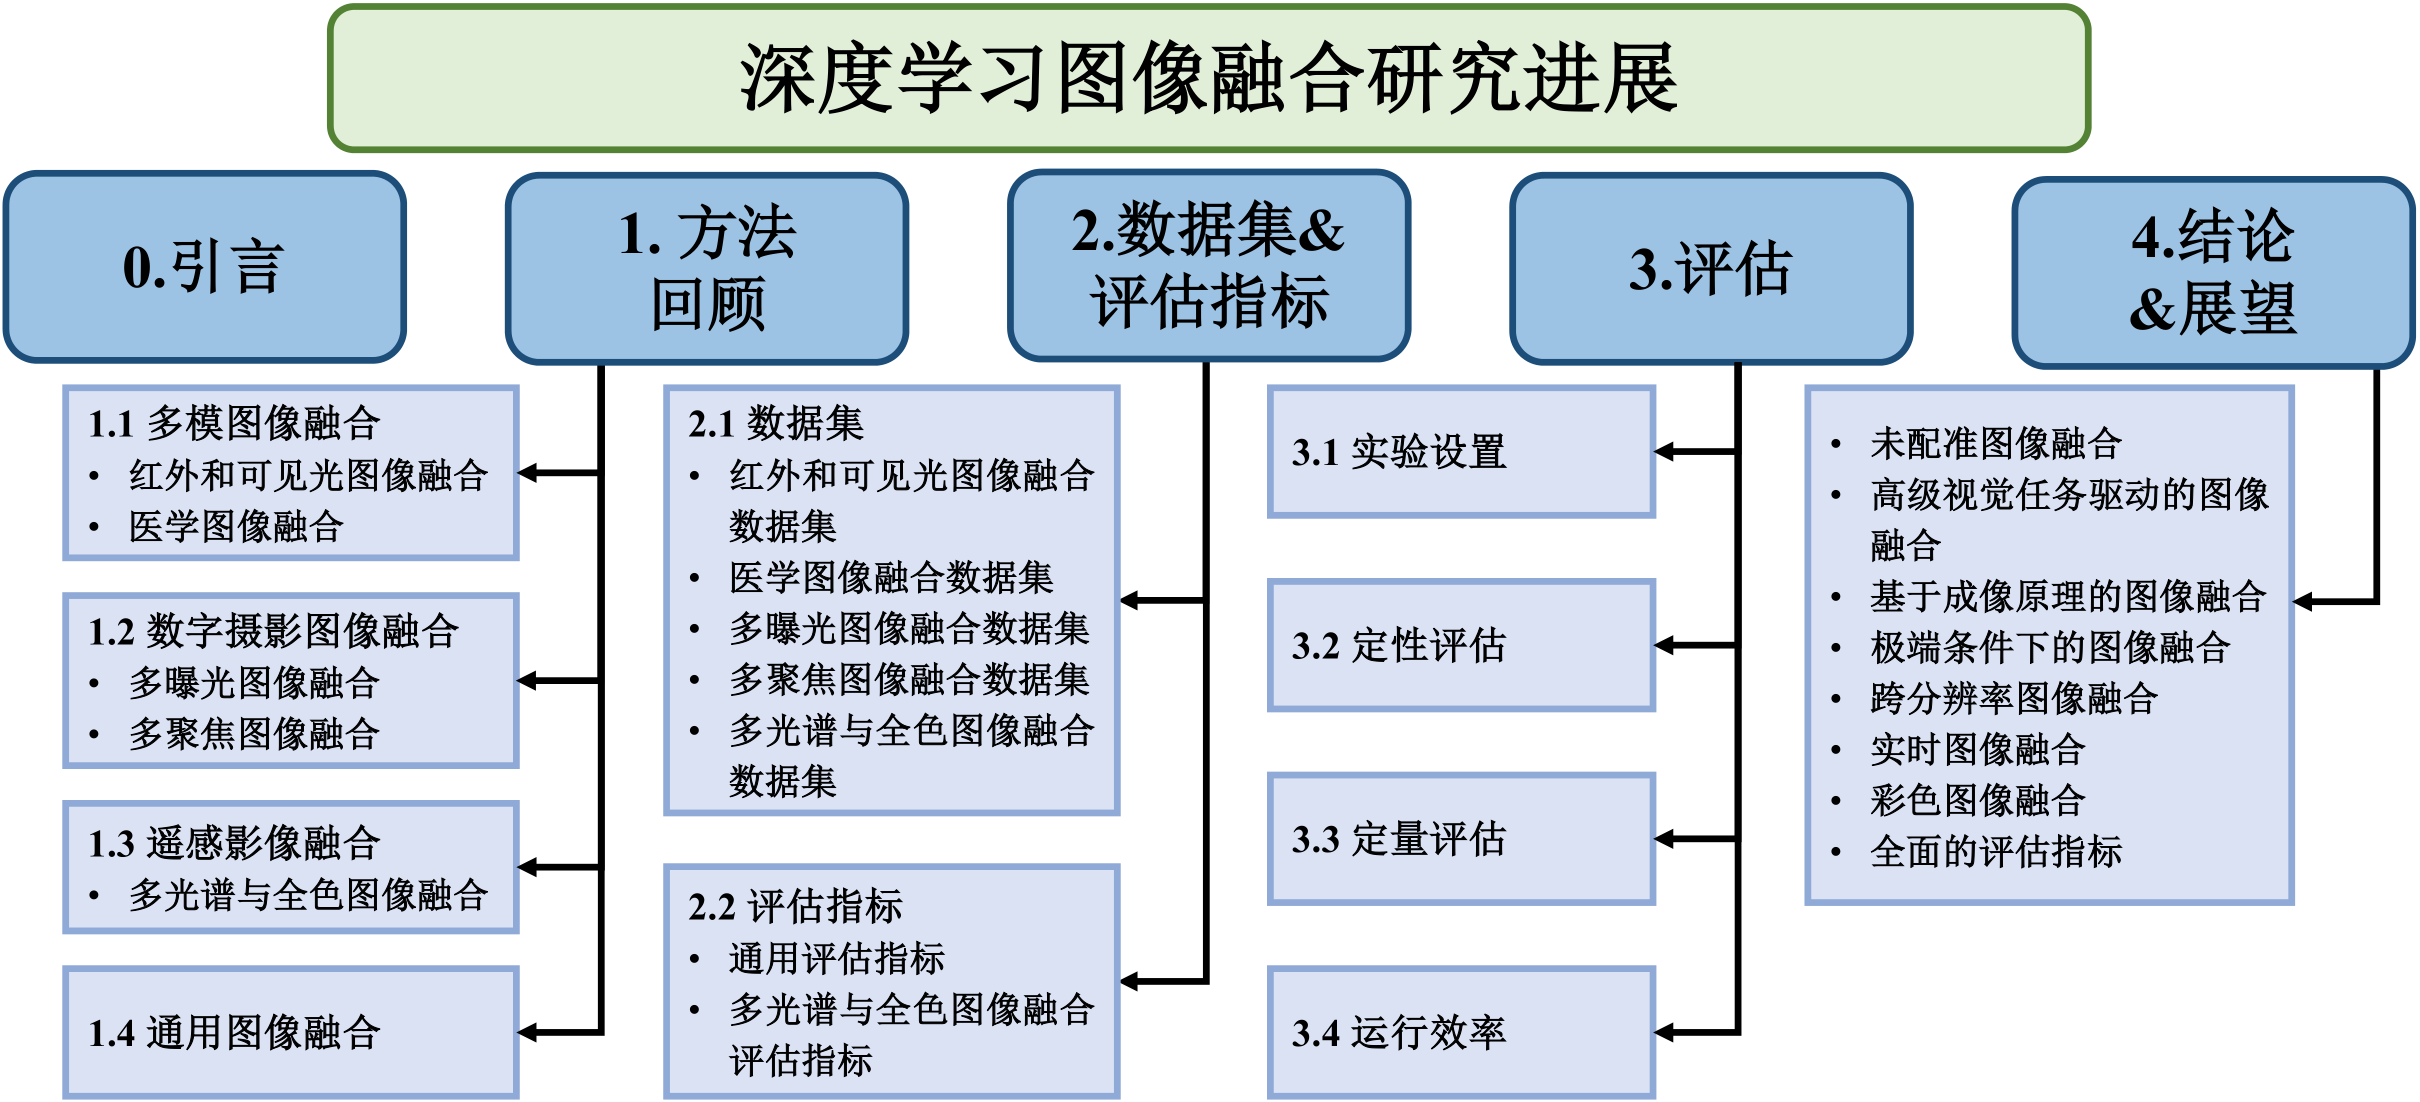
Deep Learning-based Image Fusion: A Survey
《中国图象图形学报》,2023
本页展示的引用数据已根据本人 Google Scholar 主页于 2026 年 7 月 18 日更新,实时数据请以 Google Scholar 为准。
学术服务
目前担任 TPAMI、TIP、TNNLS、TMM、TCSVT、TII、TGRS、TITS、TSMC、TASE、JSAC、JAS、IoTJ、IJCV、Information Fusion、PR,以及 CVPR、NeurIPS、ECCV、AAAI、IJCAI、ACM MM 等期刊和会议审稿人。完整列表见 学术服务 页面。
News
| Oct 20, 2026 | 入选 2026 年度湖北省博士后尖端人才引进项目。 |
|---|---|
| Oct 09, 2026 | 获评 NeurIPS 2026 Top Reviewer。 |
| Oct 08, 2026 | 入选 2026 年全球前 2% 顶尖科学家榜单(Stanford University/Elsevier),连续两年(2025、2026)入选。 |
| Sep 25, 2026 | 论文 CoVisIT: Cross-Modal Prior Guided Diffusion Model for Visible-to-Infrared Image Translation 被 NeurIPS 2026 正式接收(CCF A 类)。[Code] |
| Sep 21, 2026 | 获批 省级青年基金:生成式多源图像自适应融合与可信感知一体化方法研究。 |
Selected Publications
- NeurIPS
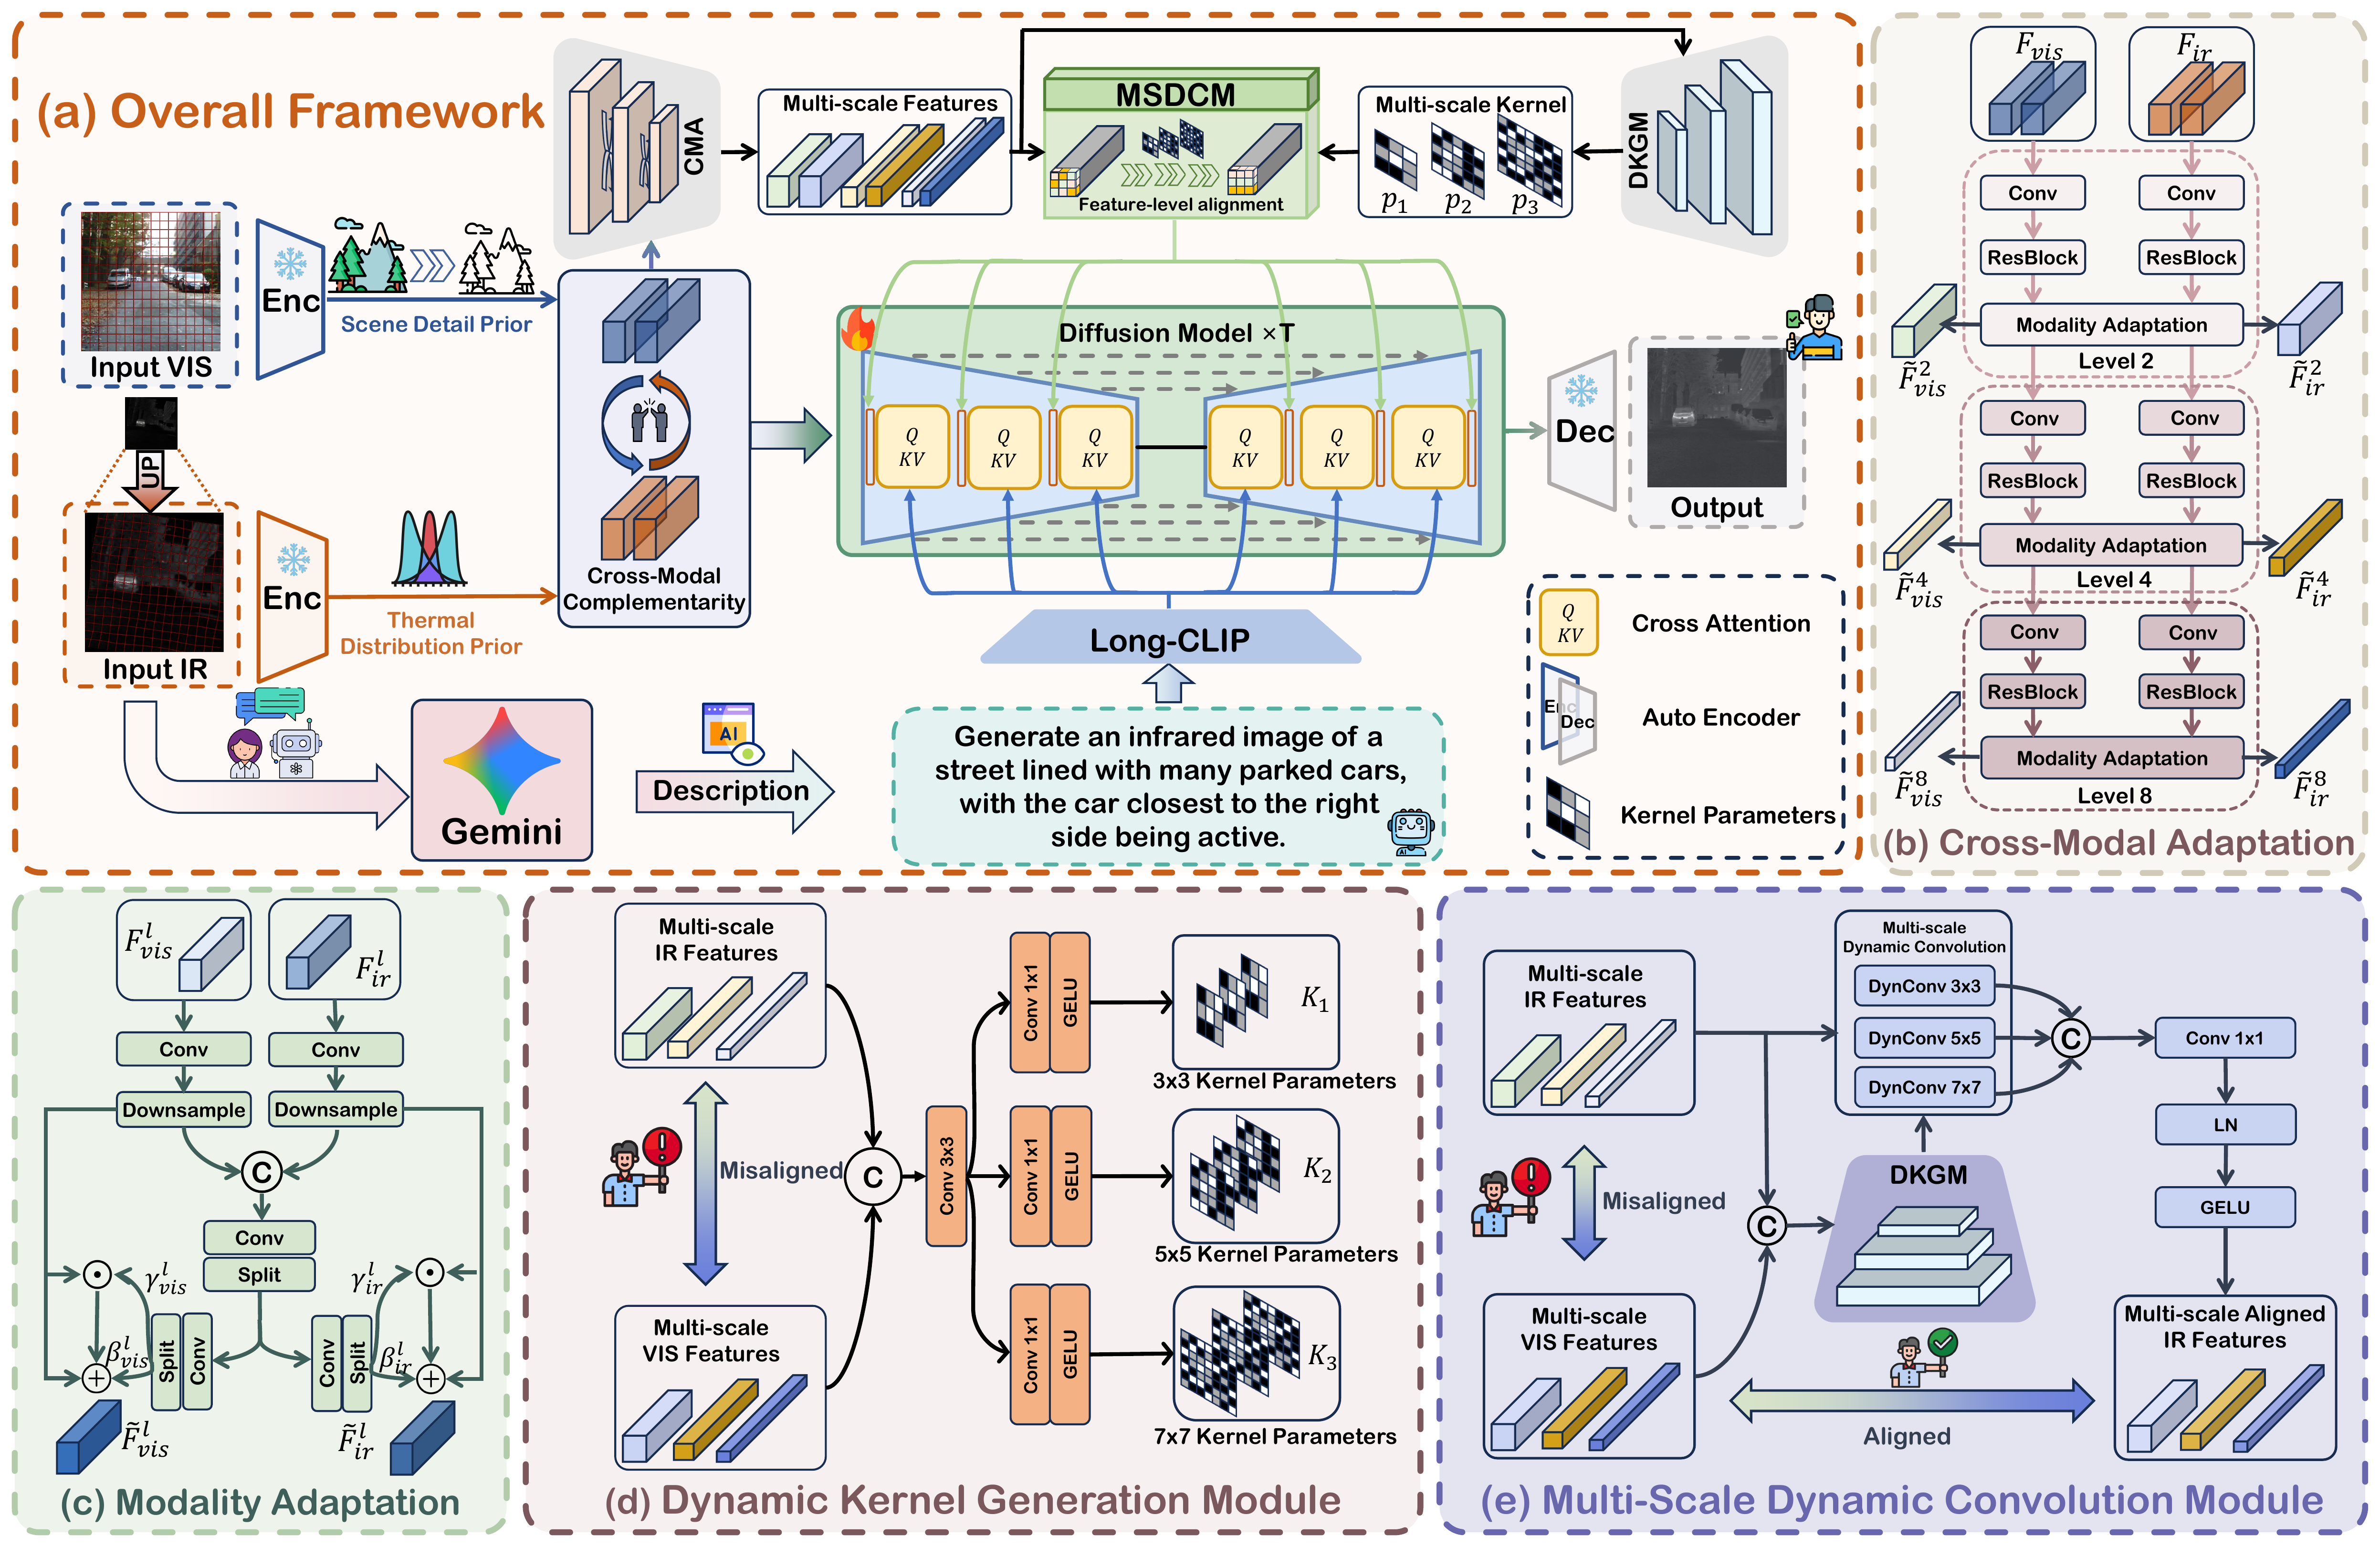 CoVisIT: Cross-Modal Prior Guided Diffusion Model for Visible-to-Infrared Image TranslationIn Advances in Neural Information Processing Systems (NeurIPS), 2026CCF A
- IEEE TPAMI
- Inf. Fusion
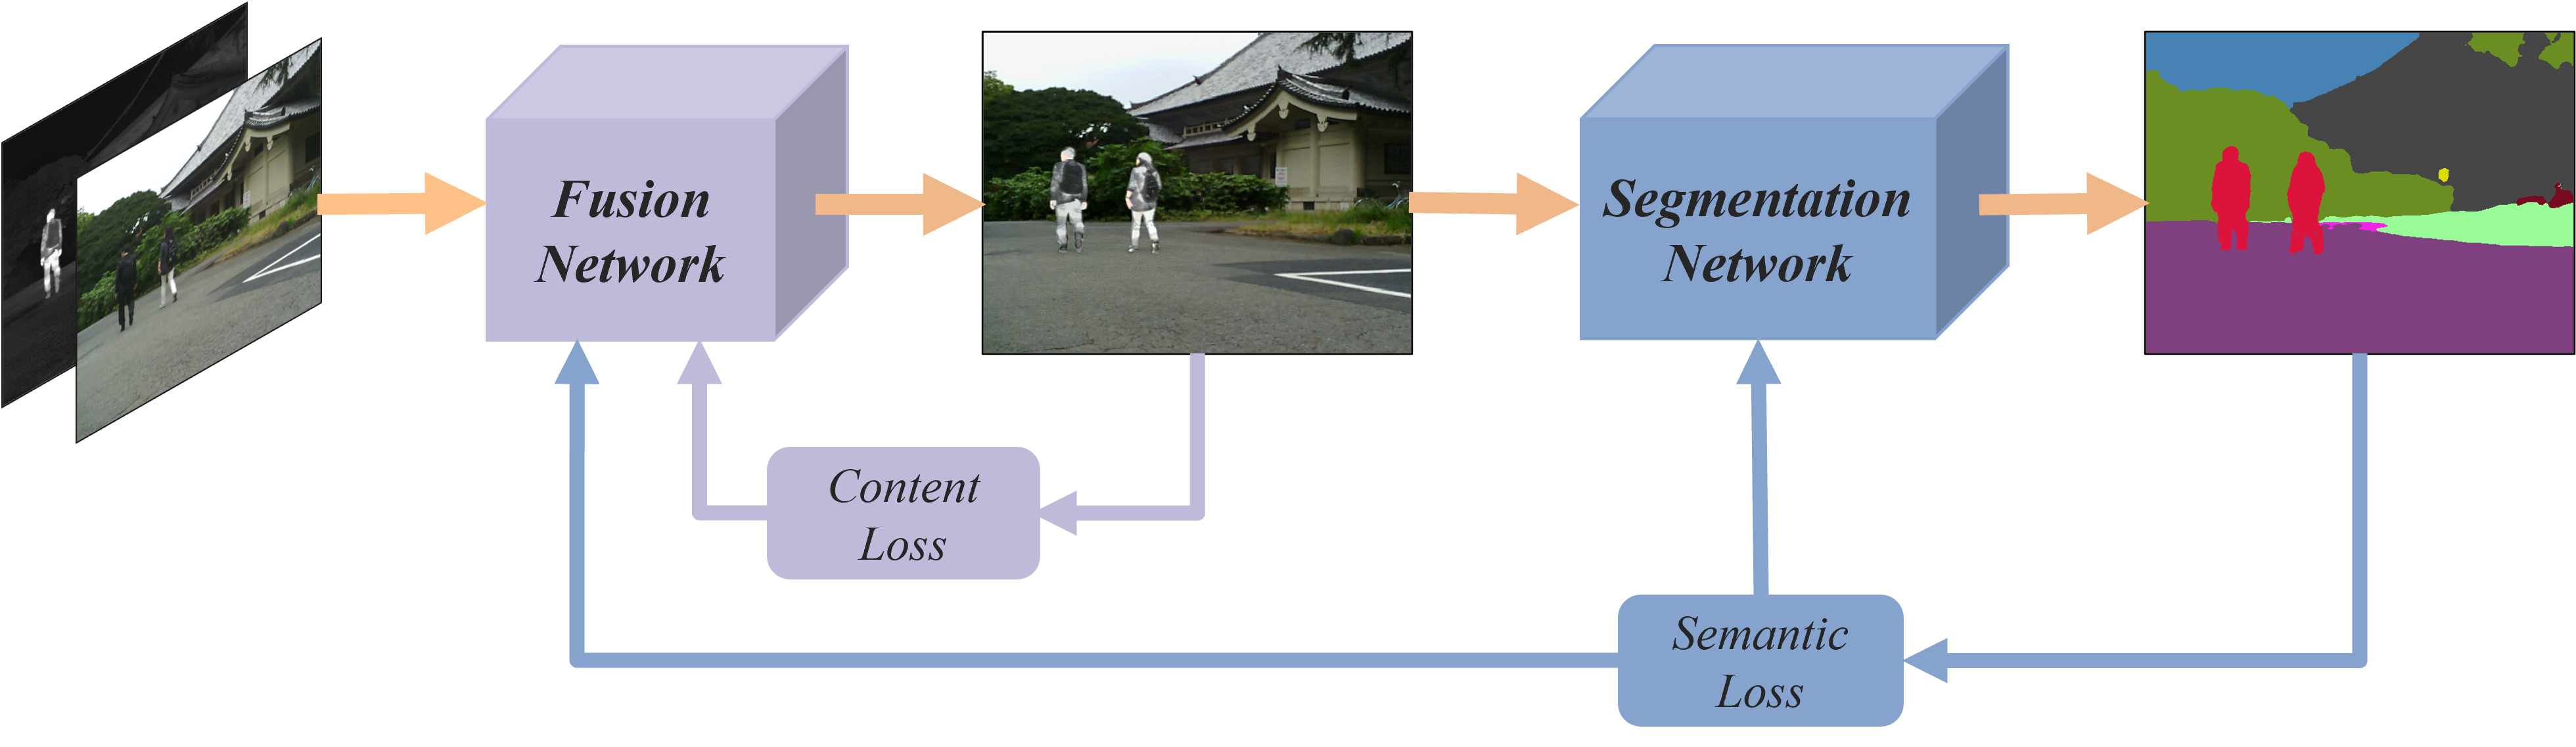 Image fusion in the loop of high-level vision tasks: A semantic-aware real-time infrared and visible image fusion networkInformation Fusion, 2022Semantic-aware real-time infrared-visible fusion with high-level task feedback; Information Fusion Best Paper Award 2024; ESI Hot Paper; ESI Highly Cited Paper Google Scholar citations
- IEEE/CAA JAS
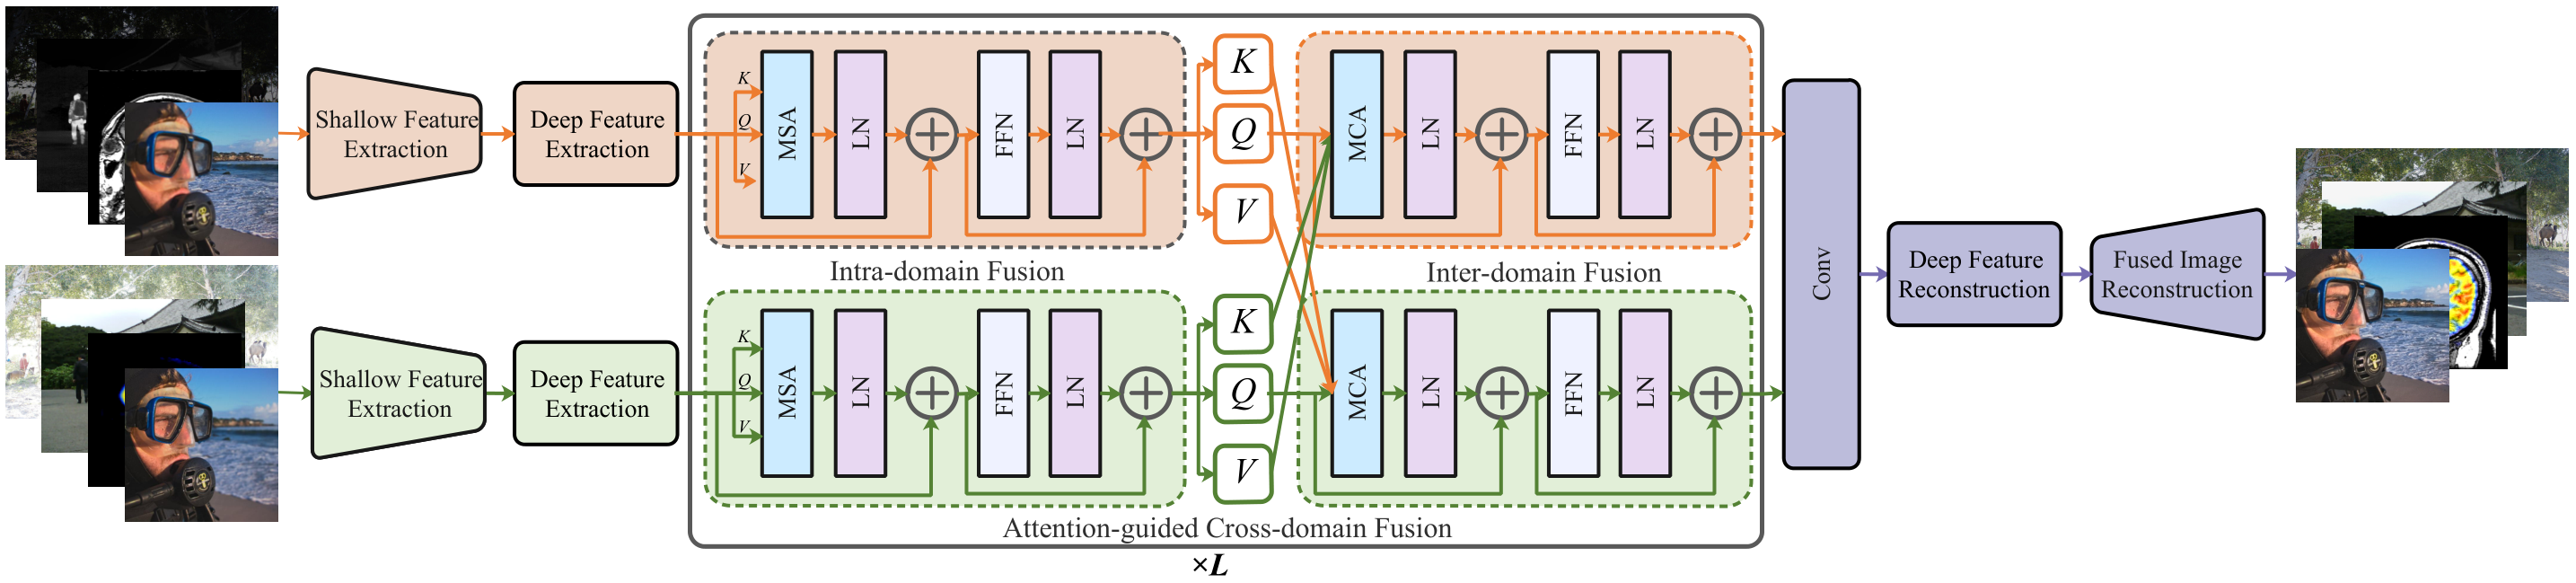 SwinFusion: Cross-domain Long-range Learning for General Image Fusion via Swin TransformerIEEE/CAA Journal of Automatica Sinica, 2022Cross-domain long-range modeling with a Swin Transformer for general image fusion; IEEE/CAA JAS 2023 Best Paper Award, sole annual winner; ESI Hot Paper; ESI Highly Cited Paper Google Scholar citations
- IEEE/CAA JAS
- Inf. Fusion
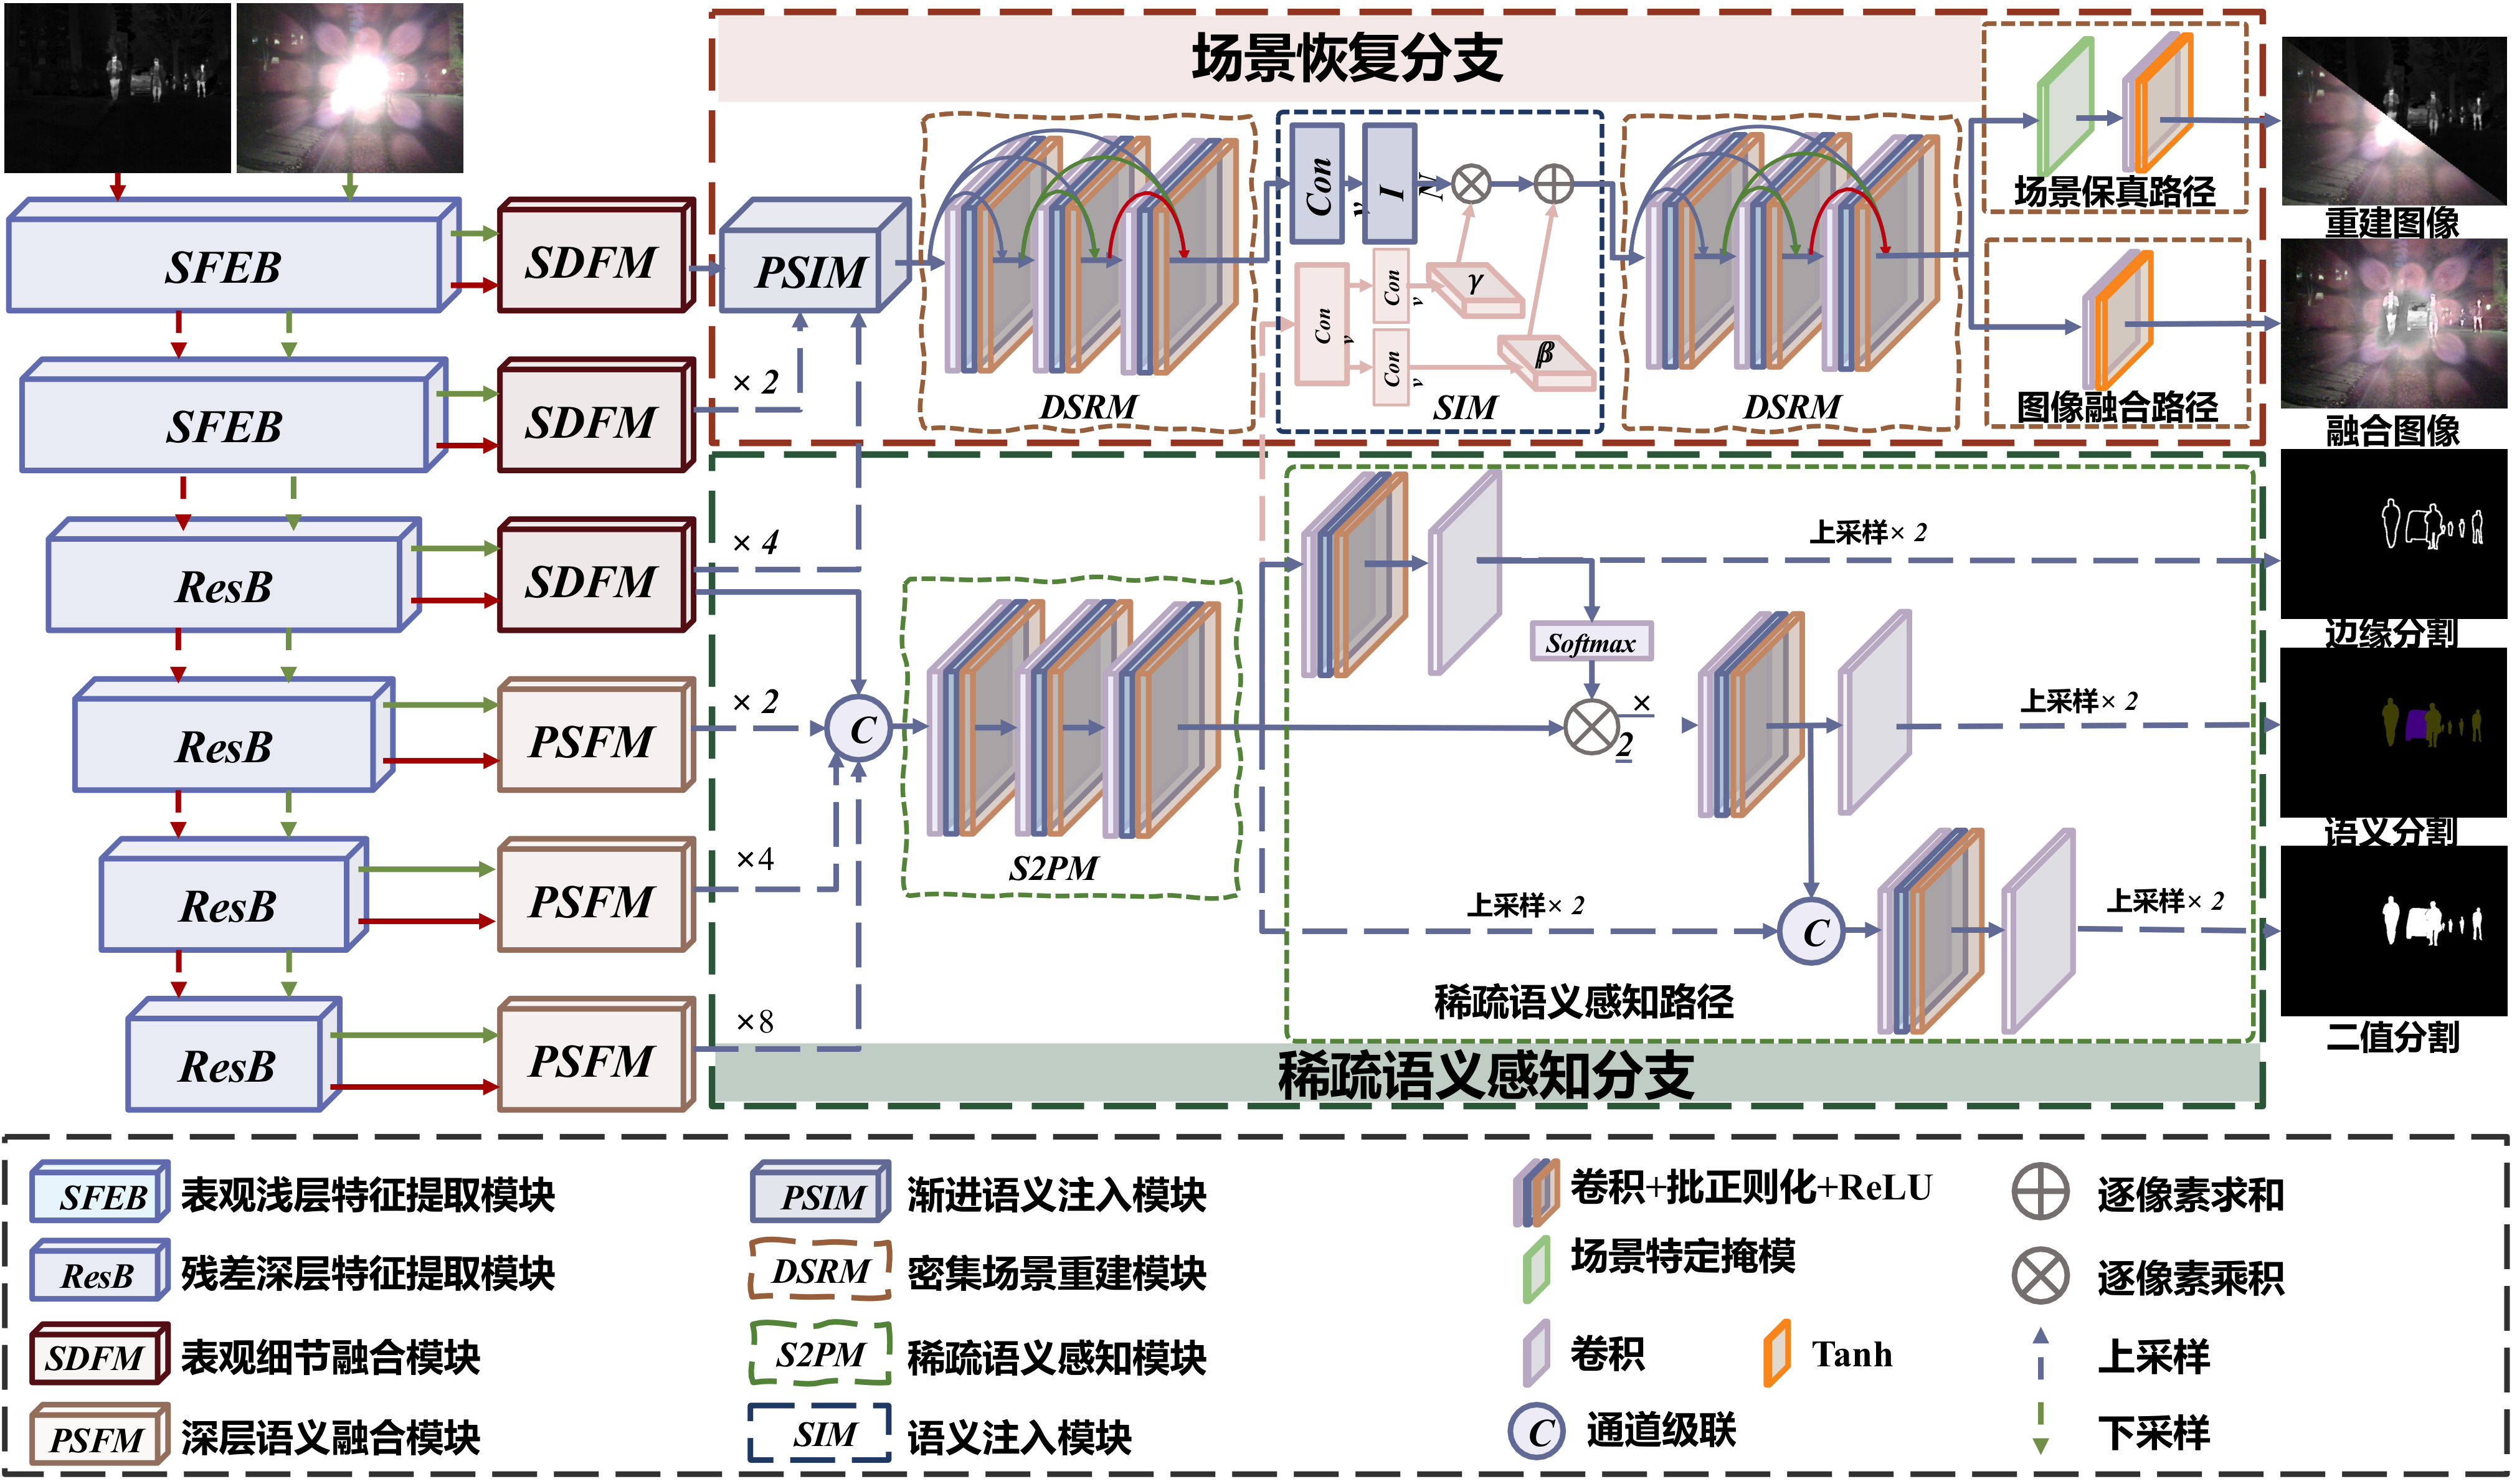 Rethinking the necessity of image fusion in high-level vision tasks: A practical infrared and visible image fusion network based on progressive semantic injection and scene fidelityInformation Fusion, 2023Progressive semantic injection and scene fidelity for task-oriented fusion; ESI Hot Paper; ESI Highly Cited Paper Google Scholar citations